
Quiconque fait tourner des modèles d'IA locaux avec Ollama, LM Studio ou d'autres applications sur des Mac à puce Apple Silicon se pose tôt ou tard une question décisive : dans quelle mesure peut-on compresser un modèle de langage sans que la qualité de ses réponses en pâtisse ? Les modèles d'IA modernes nécessitent parfois d'énormes quantités de mémoire vive. Grâce à ce qu'on appelle la quantification, ce besoin peut être considérablement réduit, de sorte que même des modèles performants peuvent être exécutés sur du matériel relativement abordable. Mais tous les niveaux de compression ne conviennent pas de la même manière aux tâches exigeantes.
Entre Q2, Q4, Q8 et FP16, il existe des différences nettes en termes de besoin en mémoire, de vitesse et de précision. Ces différences peuvent être décisives, notamment pour les analyses complexes, les tâches de programmation ou le traitement de ses propres documents. Cet article explique les bases techniques de la quantification, compare les formats courants comme GGUF et MLX et montre les effets des différents niveaux de précision sur les systèmes d'IA locaux. Des recommandations pratiques aident à trouver un compromis judicieux entre performance, consommation de mémoire et qualité des réponses pour son propre matériel et son cas d'usage.

Ce que signifie la quantification pour les modèles locaux
Les modèles de langage ne se distinguent pas seulement par leurs capacités, mais aussi par le format technique dans lequel ils se présentent. Ces formats déterminent comment un modèle est stocké, chargé et utilisé – et s'il est même exécutable sur un système donné. Pour une utilisation locale dans des outils comme Ollama, LM Studio ou Llama.cpp, le format GGUF s'est imposé. Il est compact, portable et hautement optimisé pour l'inférence sur différentes plateformes.
Les modèles GGUF sont généralement quantifiés, ce qui signifie que les valeurs numériques internes sont stockées de manière réduite, par exemple en précision 4 bits ou 8 bits. Cela permet de compresser des modèles qui faisaient à l'origine 30 à 50 Go à 5 à 10 Go – avec seulement une faible perte de qualité. L'avantage : GGUF fonctionne sur presque tous les systèmes, de macOS à Windows en passant par Linux, sans nécessiter de GPU spécifique. L'inconvénient : le format n'est pas conçu pour l'entraînement ou le réglage fin, mais exclusivement pour l'utilisation pure.
Outre GGUF, il existe d'autres formats. MLX est le framework open source d'Apple pour le machine learning sur Apple Silicon. Il a été spécialement conçu pour exploiter toute la puissance du CPU, du GPU et du Neural Engine des puces M. Les modèles MLX se présentent généralement au format MLX natif ou sont convertis à partir d'autres formats. L'avantage : des performances et une efficacité énergétique maximales sur le matériel Apple. L'inconvénient : l'écosystème est encore relativement jeune, et il y a moins de modèles communautaires disponibles qu'avec GGUF ou PyTorch.
Safetensors vient du monde PyTorch et est fortement soutenu par Hugging Face. C'est un format de stockage binaire sûr pour les grands modèles, qui n'autorise aucune exécution de code – d'où le nom „ safe “. L'avantage : très rapide à charger, économe en mémoire et standardisé. L'inconvénient : il est principalement destiné aux frameworks comme PyTorch ou TensorFlow, donc plutôt courant dans les environnements de développement et pour les processus d'entraînement. Il n'est pas compatible pour une utilisation directe avec Ollama ou MLX.
La quantification expliquée simplement : pourquoi l'IA a besoin de moins de mémoire | vue d'ensemble
Q4, Q8 et FP16 : les principaux niveaux en comparaison
Les niveaux de quantification courants diffèrent nettement en termes de précision et de besoin en mémoire. Ollama utilise par défaut une quantification 4 bits, ce qui signifie que le nombre après le „ q “ indique le nombre de bits utilisés pour la quantification. Plus le nombre est élevé, plus le modèle est précis, mais plus il tourne lentement et plus il nécessite de mémoire. En cas de problèmes avec les niveaux de quantification supérieurs, il est recommandé d'utiliser le modèle q4 ou de fermer les programmes qui consomment beaucoup de mémoire.
La quantification 8 bits offre un moyen simple de réduire les coûts sans compromettre la qualité. En réduisant la taille du modèle d'environ quatre fois par rapport au FP32, les performances restent quasiment identiques, avec une perte de précision de moins de 1 pour cent. Cela en fait une excellente option d'entrée pour les équipes qui débutent dans la quantification, et offre une option à risque faible à modéré. La quantification 4 bits est également une option pratique pour la production, tandis que le 2 bits est considéré comme risqué.
Pour les développeuses et développeurs qui font tourner des modèles locaux sur des Mac à puce Apple Silicon, le choix du niveau de quantification est un compromis entre besoin en mémoire et précision. La quantification 8 bits réduit le besoin en mémoire de 50 pour cent, accélère l'inférence d'un facteur 1,8 et conserve plus de 99 pour cent de la précision sur des benchmarks exigeants comme HumanEval. La quantification 4 bits est 11 fois plus efficace que le 2 bits en termes de réduction de taille par rapport à la perte de qualité. Pour les applications où la précision est cruciale, la quantification 8 bits (INT8 ou FP8) offre une qualité quasi sans perte.
L'influence sur la qualité des réponses : où commence la perte de qualité ?
La perte de qualité aux niveaux de quantification inférieurs est mesurable et dépend de la taille du modèle. Dans un benchmark de janvier 2026, la configuration Q4_K_M (4 bits) a réduit la taille de Mistral-7B-Instruct-v0.2 de 7,2 Go à 4,1 Go – une réduction de 43,1 pour cent – tandis que la perte de qualité en perplexité n'était que de 0,51 pour cent, ce qui est considéré comme quasi négligeable. Une réduction supplémentaire à 2 bits (Q2_K) a toutefois entraîné une forte perte de précision de 7,94 pour cent, ce qu'on appelle une „ falaise de qualité “.
La variante 70B est plus sensible à la quantification. Llama 3.3 70B a subi une baisse notable de 7,8 points sur le benchmark MMLU lorsqu'il a été réduit à 4 bits. Cette dégradation contraste avec la robustesse de modèles plus petits comme la version 8B. Des évaluations de performance d'octobre 2024 montrent que les modèles quantifiés en 8 bits conservent 99,9 pour cent de la précision de leurs équivalents en pleine précision, tandis que les modèles en 4 bits maintiennent environ 98,9 pour cent sur des benchmarks comme HumanEval+.
Red Hat Developer a réalisé plus d'un demi-million d'évaluations et a constaté que les modèles bien quantifiés récupèrent en moyenne 99 pour cent du score de référence, tous les modèles présentant au moins 96 pour cent de récupération. La qualité des réponses des modèles quantifiés reste hautement compétitive par rapport à leurs homologues non quantifiés. Les intervalles de confiance à 95 pour cent se chevauchent pour toutes les tailles de modèles et tous les schémas de quantification, ce qui souligne l'impact minimal sur la précision.
Consommation de RAM et vitesse sur Apple Silicon
Lorsqu'un modèle de langage s'exécute localement, la mémoire vive (RAM, ou chez Apple : „ Unified Memory “) revêt une importance centrale. Le modèle lui-même, y compris les poids, les activations et les résultats intermédiaires, doit être conservé en mémoire. Plus le modèle est grand, plus il nécessite de mémoire. Les puces Apple Silicon utilisent la „ Unified Memory “, ce qui signifie que le CPU, le GPU et le Neural Engine accèdent au même pool de mémoire. Cela élimine les copies de données entre les composants, ce qui augmente l'efficacité et la vitesse.
Si la RAM disponible est insuffisante, le système doit recourir au swap ou les modèles ne sont pas entièrement chargés – ce qui peut entraîner des baisses de performances, de l'instabilité ou un arrêt. C'est précisément dans les applications inférentielles, comme la génération de réponses, la saisie de texte ou l'extension de modèle, que le temps de réaction et le débit comptent, et une mémoire suffisante y contribue considérablement. Un PC de bureau traditionnel raisonnait autrefois en „ RAM CPU “ et „ RAM GPU séparée “ – chez Apple Silicon, tout est élégamment unifié, ce qui rend l'exécution de modèles de langage particulièrement attrayante.
Pour les modèles plus petits, par exemple avec quelques milliards de paramètres, 16 à 32 Go de RAM pourraient suffire, en particulier si seules des requêtes individuelles doivent être traitées. Un Mac Mini avec 16/32 Go serait donc un point d'entrée. Pour les modèles moyens, par exemple avec 3 à 10 milliards de paramètres, ou pour des tâches avec plusieurs chats parallèles ou de plus grands volumes de texte, il faudrait envisager 32 Go de RAM ou plus, par exemple un Mac Studio avec 32 ou 48 Go. Pour les grands modèles, au-delà de 20 milliards de paramètres, ou si plusieurs modèles doivent fonctionner en parallèle, on pourrait choisir 64 Go ou plus.
Il est important de prévoir une marge, car non seulement le modèle, mais aussi l'exploitation, comme le système d'exploitation, les entrées-sorties de fichiers ou d'autres applications, nécessitent des réserves de mémoire. Pour les petits modèles (1-3 Mrd de paramètres), 16-32 Go de RAM sont recommandés, pour les modèles moyens (7-13 Mrd de paramètres) 32-64 Go, et pour les grands modèles (30-70 Mrd de paramètres) 64 Go ou plus. Cela permet d'exploiter efficacement des modèles comme qwen3-coder:30b avec 19 Go en Q4_K_M ou gpt-oss:20b avec 16 Go de RAM.
Recommandation pratique : quel niveau pour quel cas d'usage ?
Le choix du niveau de quantification approprié dépend directement du cas d'usage concret et des exigences en matière de protection des données. Les modèles de langage locaux sont particulièrement adaptés là où la confidentialité est impérative ou lorsque des processus en temps réel sont exigés. Dans la pratique, on constate que des secteurs comme le barreau ou la médecine misent sur des solutions locales pour traiter des données sensibles de patients ou des actes de procédure sans dépendance au cloud. Dans la production de livres et de médias ou dans le domaine des systèmes ERP également, les modèles locaux permettent des analyses de texte automatiques et des suggestions générées directement depuis le logiciel. Pour les bureaux d'études et les architectes, ces assistants sont en outre un avantage, car ils fonctionnent de manière fiable même sans connexion Internet. Les entreprises bénéficient généralement d'assistants de chat internes et d'analyses de journaux qui restent entièrement dans leur propre réseau.
Un avantage pratique essentiel des modèles locaux par rapport aux services cloud est la vitesse de réaction. Alors que les API externes peuvent être retardées par les chemins réseau ou la charge des serveurs, les modèles locaux répondent presque en temps réel selon le matériel. C'est décisif pour le flux de travail, en particulier pour les tâches répétitives ou les processus interactifs, comme une analyse de données en direct. Dans le domaine professionnel, l'exploitation sur ses propres machines permet en outre l'adaptation et l'ajustement fin des modèles avec le savoir propre à l'entreprise. Il en résulte un paysage informatique qui utilise la technologie moderne sans renoncer à la maîtrise de ses propres données. La décision en faveur d'un niveau de quantification particulier ne doit donc pas être considérée isolément, mais comprise comme partie d'une stratégie qui allie souveraineté et performance.
Quantification dans les systèmes RAG : particularités à prendre en compte
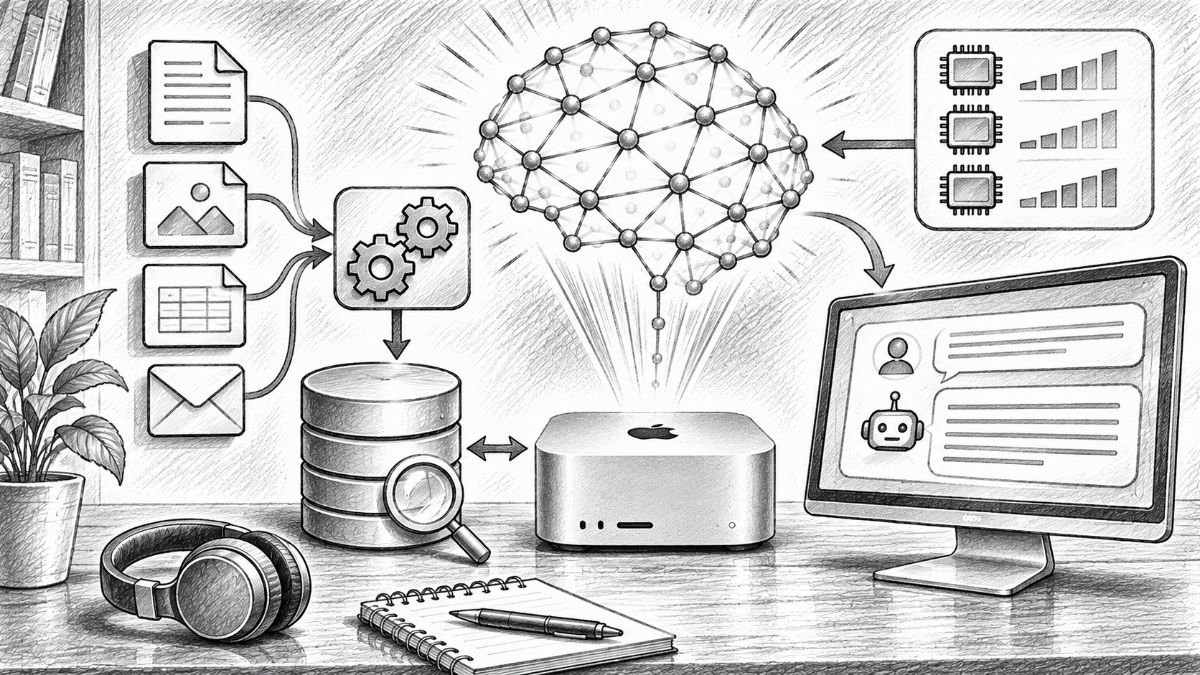
Dans les systèmes de génération augmentée par récupération (RAG), la quantification joue un rôle central, car le modèle de langage y est combiné à une recherche dans des collections de documents ou des bases de données. Ce procédé sert à accroître la fiabilité des réponses générées et à combler les lacunes de connaissances du modèle par des connaissances externes. Le RAG est particulièrement utile dans les scénarios à forte intensité de connaissances, car il peut atténuer les hallucinations en permettant au modèle de recourir à des informations pertinentes et actualisées. Cela permet d'exploiter le potentiel des grands modèles de langage pour des données internes, sans devoir procéder à des ajustements fins coûteux.
La mise en œuvre technique exige que les documents soient d'abord divisés en sections plus petites et transformés en forme vectorielle (embeddings) via Ollama. Ces vecteurs sont ensuite insérés dans une base de données appropriée, comme Qdrant. Lors du choix du niveau de quantification pour le processus d'embedding, il faut noter qu'une compression trop agressive peut nuire au calcul de similarité. Dans la pratique, il convient donc de peser si l'économie de mémoire obtenue par des niveaux inférieurs justifie la réduction potentielle de la précision de recherche. On constate souvent que, pour les modèles d'embedding, une précision plus élevée que pour le modèle de langage génératif lui-même est avantageuse, afin de garantir que les bons fragments de contexte soient récupérés.
Le choix du niveau de quantification est en fin de compte un compromis entre consommation de ressources et précision. Pour les systèmes RAG, il s'agit d'harmoniser la précision de la recherche et la performance du générateur afin d'obtenir des résultats fiables.
Sources sur la quantification des LLM
- Apple MLX vs. NVIDIA : comment fonctionne l'inférence IA locale sur Mac
- IA locale sur Mac : comment installer un modèle de langage avec Ollama
- RAG avec Ollama et Qdrant comme moteur de recherche universel pour ses propres données
- llama2
- Nous avons testé des LLM quantifiés : résultats de coût et de performance | Latitude
- Nous avons mené plus d'un demi-million d'évaluations sur des LLM quantifiés — voici ce que nous avons découvert | Red Hat Developer
- Meilleurs modèles Ollama 2026 : 25+ classés par VRAM & SWE-Bench (octobre 2026) | Morph
- Retrieval Augmented Generation (RAG) : chat avec ses propres données
- Retrieval Augmented Generation (RAG) pour les LLM | Prompt Engineering Guide

Questions fréquemment posées sur la quantification des modèles d'IA locaux
Que signifie la quantification pour un modèle de langage d'IA ?
La quantification désigne une méthode par laquelle la précision numérique des poids d'un modèle de langage d'IA est réduite. Alors que les modèles non quantifiés fonctionnent souvent avec des nombres à virgule flottante de 16 bits ou 32 bits, les variantes quantifiées n'utilisent par exemple plus que 8, 4 ou même 2 bits par poids. Cela réduit considérablement l'espace de stockage nécessaire, sans que le modèle doive être entièrement réentraîné. L'avantage décisif est que des modèles de langage plus grands peuvent également être exécutés sur des ordinateurs disposant d'une mémoire vive limitée. Par exemple, un modèle qui nécessitait initialement environ 60 Go de mémoire pour ses poids peut, grâce à une quantification sur 4 bits, être réduit à environ 15 à 20 Go. La taille réelle dépend de la méthode de quantification utilisée. Cependant, la conversion entraîne une perte d'informations, raison pour laquelle la qualité des réponses peut être altérée plus ou moins fortement selon le modèle et le cas d'usage.
Quelle est la différence entre Q2, Q4, Q8 et FP16 ?
Les désignations Q2, Q4, Q8 et FP16 décrivent différents niveaux de précision lors du stockage des poids du modèle. FP16 utilise des nombres à virgule flottante de 16 bits et offre une précision numérique élevée, mais nécessite en contrepartie comparativement beaucoup de mémoire vive. Q8 réduit les poids à environ 8 bits et atteint souvent une qualité de réponse quasiment inchangée pour un besoin en mémoire nettement moindre. Q4 utilise majoritairement 4 bits par poids et constitue donc pour de nombreuses applications locales un compromis particulièrement attractif. La consommation de mémoire diminue considérablement, tandis que la qualité reste à un niveau élevé pour de nombreux modèles. Q2 comprime encore davantage, mais peut toutefois entraîner des pertes de qualité nettement plus importantes. Il est important de noter que ces désignations ne décrivent que la précision de base. Des variantes de quantification comme Q4_K_M utilisent des procédés supplémentaires afin de préserver au mieux la précision des poids de modèle particulièrement importants.
Quelle quantité de mémoire vive peut-on réellement économiser grâce à la quantification ?
L'économie de mémoire possible dépend de la précision d'origine, de la taille du modèle et du procédé de quantification choisi. Par rapport à FP16, une représentation pure sur 8 bits nécessite environ la moitié de la mémoire pour les poids du modèle. Avec 4 bits, ce besoin théorique tombe à environ un quart. En pratique, les modèles sont un peu plus volumineux, car des informations supplémentaires sur la quantification doivent être stockées. Un modèle de langage de 30 milliards de paramètres nécessite en FP16, rien que pour ses poids, environ 60 Go. Une variante sur 8 bits nécessite environ 30 Go, tandis qu'une version sur 4 bits se situe souvent autour de 18 à 20 Go. Ces valeurs ne décrivent toutefois pas l'intégralité du besoin en mémoire vive pendant l'utilisation. Il faut en outre tenir compte, entre autres, de la mémoire de contexte, des calculs temporaires et du système d'exploitation. C'est pourquoi il convient toujours de prévoir une réserve de mémoire suffisante lors du choix d'un modèle.
Dans quelle mesure la quantification Q4 dégrade-t-elle la qualité des réponses d'un modèle de langage ?
Pour de nombreux modèles de langage modernes, une quantification de haute qualité sur 4 bits n'entraîne que des pertes de qualité comparativement faibles. En particulier pour les tâches courantes comme les résumés de texte, les traductions, les tâches de programmation simples ou les questions de culture générale, les différences par rapport aux variantes plus précises sont souvent à peine perceptibles. Toutefois, la qualité réelle dépend fortement du modèle concerné et de la tâche. Pour les calculs mathématiques complexes, les tâches de programmation exigeantes ou les raisonnements logiques en plusieurs étapes, de petits écarts numériques peuvent avoir des répercussions plus importantes. La méthode de quantification choisie joue également un rôle. Des procédés comme Q4_K_M tentent de préserver avec une précision supérieure les zones du modèle particulièrement sensibles. Pour de nombreux utilisateurs, Q4 constitue donc un point de départ judicieux. Ceux qui ont besoin de résultats particulièrement fiables devraient en outre tester le même modèle en Q8 et comparer les réponses à l'aide de tâches typiques.
Quand Q8 ou FP16 valent-ils la peine au lieu d'une version Q4 plus petite ?
Une précision supérieure peut notamment être judicieuse lorsqu'un modèle de langage doit accomplir des tâches exigeantes et qu'une mémoire vive suffisante est disponible. Cela inclut par exemple le développement logiciel complexe, les évaluations scientifiques, les calculs mathématiques ou les analyses approfondies comportant plusieurs étapes de réflexion successives. Q8 offre alors souvent un bon compromis. Les poids du modèle nécessitent environ deux fois plus de mémoire que pour une quantification comparable sur 4 bits, mais la qualité est en contrepartie généralement très proche de la version d'origine plus précise. FP16 entre surtout en ligne de compte lorsque la précision numérique maximale est requise et que le matériel peut gérer le besoin en mémoire considérable. FP16 n'offre toutefois pas non plus de garantie de réponses exemptes d'erreurs. Pour de nombreuses applications pratiques, un modèle plus performant en Q4 est peut-être le meilleur choix qu'un modèle nettement plus petit en FP16.
Pourquoi les modèles d'IA quantifiés sur 2 bits peuvent-ils être problématiques ?
Avec une quantification sur 2 bits, nettement moins de paliers sont disponibles pour la représentation des poids du modèle qu'avec 4 ou 8 bits. Les modèles de langage peuvent ainsi être compressés de manière particulièrement forte, mais des informations importantes sur les corrélations au sein du réseau neuronal peuvent être perdues. Ces pertes ne se manifestent pas nécessairement pour des questions simples. Les difficultés n'apparaissent souvent qu'avec des tâches plus complexes qui exigent des calculs précis, des raisonnements longs ou le traitement fiable d'informations volumineuses. Les réponses peuvent alors devenir moins précises, plus contradictoires ou moins stables. Ce qui est particulièrement problématique, c'est que de telles pertes de qualité ne sont pas toujours évidentes. Un modèle peut continuer à formuler de manière convaincante, alors que ses résultats contiennent des erreurs factuelles. Q2 convient donc avant tout aux applications expérimentales ou aux situations où la mémoire est très limitée. Pour les systèmes de production exigeants, Q4 et Q8 constituent généralement la base de départ la plus fiable.
Quelles différences existent entre GGUF, MLX et Safetensors ?
GGUF, MLX et Safetensors sont souvent mentionnés dans le contexte des modèles d'IA locaux, mais remplissent des fonctions différentes. GGUF est un format de modèle particulièrement répandu dans l'environnement de llama.cpp, Ollama et LM Studio. Il prend en charge différents procédés de quantification et permet l'exécution de modèles de langage sur différentes plateformes matérielles. MLX est en revanche un framework d'apprentissage automatique développé par Apple, spécifiquement orienté vers l'architecture d'Apple Silicon. Avec MLX, les modèles de langage peuvent être exécutés efficacement sur des Mac équipés de processeurs M. Des variantes de modèles spécialement quantifiées sont également disponibles à cet effet. Safetensors est un format de fichier sécurisé pour le stockage des poids de modèles numériques. Il est souvent utilisé dans l'environnement de Hugging Face et de PyTorch. Le choix du format dépend donc de l'environnement d'exécution utilisé. Sur les Mac Apple Silicon, les modèles GGUF comme les modèles MLX peuvent être pertinents, leur vitesse différant selon le modèle et l'implémentation.
Les modèles d'IA quantifiés deviennent-ils automatiquement plus rapides ?
Pas nécessairement. La quantification réduit d'abord le besoin en mémoire d'un modèle. De ce fait, moins de données doivent souvent être lues depuis la mémoire vive pendant le traitement, ce qui peut apporter des avantages considérables, notamment pour les calculs dépendant de la bande passante mémoire. Sur les Mac Apple Silicon, cet effet est particulièrement intéressant, car le CPU et le GPU accèdent à un pool de mémoire partagé. Des poids de modèle plus petits peuvent être transférés et traités plus efficacement. C'est pourquoi les modèles quantifiés atteignent dans de nombreux cas une vitesse supérieure lors de la génération de texte. Toutefois, le traitement des poids quantifiés nécessite parfois des opérations de calcul supplémentaires pour reconstituer des valeurs numériques appropriées. La variante réellement la plus rapide dépend donc du matériel, du logiciel utilisé et du procédé de quantification concret. Outre la vitesse pure en tokens par seconde, il convient également de tenir compte du temps jusqu'à la première réponse. Justement pour les applications interactives, un temps de réaction rapide peut être plus important que la performance de génération maximale.
Quel niveau de quantification convient aux Mac dotés de 16, 32, 64 ou 128 Go de mémoire vive ?
La quantification appropriée dépend à la fois de la capacité de mémoire disponible et de la taille du modèle de langage souhaité. Sur les Mac dotés de 16 Go de mémoire unifiée, les modèles plus petits de quelques milliards de paramètres conviennent particulièrement. Grâce à la quantification Q4, certains modèles plus grands peuvent également devenir utilisables, à condition qu'il reste suffisamment de mémoire pour le système d'exploitation et le contexte. Avec 32 Go de mémoire vive, de nombreux modèles de la classe 7B à 14B peuvent être exploités confortablement. Des modèles plus grands et fortement quantifiés sont également possibles dans certains cas. Avec 64 Go, les possibilités sont déjà nettement plus nombreuses pour les modèles de 30 milliards de paramètres ou des fenêtres de contexte plus étendues. Les Mac dotés de 128 Go de mémoire unifiée offrent en outre une marge de manœuvre pour des modèles particulièrement grands, des niveaux de précision plus élevés et l'exécution parallèle de plusieurs composants d'IA. La taille réelle du modèle reste déterminante. Le nombre de paramètres, la quantification, la longueur du contexte et l'architecture du modèle doivent toujours être considérés ensemble.
Que se passe-t-il lorsqu'un modèle d'IA nécessite plus de mémoire vive que le Mac ne peut en fournir ?
Lorsqu'un modèle de langage nécessite trop de mémoire vive, macOS peut tenter de décharger une partie des données sur le SSD. Ce mécanisme, appelé swapping, évite dans certaines circonstances un arrêt immédiat du programme, mais entraîne souvent des pertes de performances considérables dans les applications d'IA gourmandes en mémoire. La raison en est que même les SSD rapides atteignent un débit de transfert nettement inférieur à celui de la mémoire vive interne. Si le système doit constamment basculer entre le SSD et la RAM pendant la génération de texte, la vitesse de réponse peut chuter de manière drastique. De plus, macOS ne met pas toute la mémoire unifiée à disposition des applications d'IA sans restriction. Le système d'exploitation, l'interface graphique et d'autres programmes ont également besoin de mémoire. Pour éviter de tels problèmes, il convient d'abord de fermer les applications inutiles, de réduire la longueur du contexte ou d'utiliser une variante de modèle plus fortement quantifiée. Surtout pour les grands modèles de langage, une réserve de mémoire suffisante est décisive pour un fonctionnement stable et fluide.
11. Quel rôle joue la quantification dans les systèmes RAG et le traitement de ses propres documents ?
Dans la génération augmentée par récupération (RAG), les modèles de langage sont combinés à une source de connaissances externe. Les documents sont d'abord découpés en sections plus petites et convertis en vecteurs numériques à l'aide d'un modèle d'embedding. Une base de données vectorielle permet ensuite de rechercher des sections de documents pertinentes sur le plan du contenu. La quantification peut être utilisée à différents endroits. Le modèle de langage génératif peut par exemple fonctionner en Q4 pour économiser de la mémoire vive. En revanche, pour le modèle d'embedding et le stockage des vecteurs, il faut veiller tout particulièrement à préserver la qualité de la recherche de similarité. Une compression trop agressive peut entraîner une moins bonne détection des sections de documents pertinentes. Même un modèle de langage performant risque alors de ne pas recevoir les informations dont il a besoin pour fournir une réponse correcte. C'est pourquoi, dans les systèmes RAG, il convient de vérifier séparément la qualité de la recherche documentaire et la qualité des réponses du modèle de langage.
12. Comment trouver la quantification optimale pour mon système d'IA local ?
La meilleure quantification ne peut pas être déterminée uniquement à partir de la taille du modèle ou d'un tableau de benchmarks. Ce qui est décisif, ce sont les tâches que le modèle de langage doit accomplir en pratique et le matériel disponible à cet effet. Une approche raisonnable consiste à installer d'abord une variante Q4 de haute qualité du modèle souhaité. Ensuite, il convient d'effectuer des tâches typiques, par exemple des résumés de texte, des tâches de programmation, des traductions ou l'analyse de ses propres documents. Il est alors recommandé d'observer la qualité des réponses, la vitesse, la consommation de mémoire et la fiabilité. Si la mémoire est suffisante, le même modèle peut également être testé en Q8. Les résultats peuvent ensuite être comparés directement. Il est important d'utiliser des conditions de test aussi identiques que possible pour les deux variantes. C'est la seule façon de rendre les différences réellement visibles. En fin de compte, ce n'est pas la précision la plus élevée qui est décisive, mais la combinaison d'une qualité suffisante, d'une bonne vitesse et d'une exécution stable sur le matériel disponible.