
Apple Silicon Mac'lerde Ollama, LM Studio veya diğer uygulamalarla yerel yapay zeka modelleri çalıştıranlar, er ya da geç belirleyici bir soruyla karşılaşır: Bir dil modeli, yanıt kalitesi zarar görmeden ne kadar sıkıştırılabilir? Modern yapay zeka modelleri kısmen çok büyük miktarda çalışma belleği gerektirir. Niceleme adı verilen yöntemle bu ihtiyaç önemli ölçüde azaltılabilir, böylece güçlü modeller bile nispeten uygun fiyatlı donanımlarda çalıştırılabilir. Ancak her sıkıştırma seviyesi, zorlu görevler için aynı derecede uygun değildir.
Q2, Q4, Q8 ve FP16 arasında bellek gereksinimi, hız ve doğruluk açısından belirgin farklar vardır. Özellikle karmaşık analizlerde, programlama görevlerinde veya kendi belgelerinizin işlenmesinde bu farklar belirleyici olabilir. Bu makale nicelemenin teknik temellerini açıklar, GGUF ve MLX gibi yaygın formatları karşılaştırır ve farklı hassasiyet seviyelerinin yerel yapay zeka sistemleri üzerindeki etkilerini gösterir. Pratik öneriler, kendi donanımınız ve ilgili kullanım amacınız için performans, bellek tüketimi ve yanıt kalitesi arasında mantıklı bir uzlaşma bulmanıza yardımcı olur.


Yerel modellerde niceleme ne anlama gelir
Dil modelleri yalnızca yetenekleriyle değil, aynı zamanda bulundukları teknik formatla da farklılık gösterir. Bu formatlar, bir modelin nasıl saklandığını, yüklendiğini ve kullanıldığını ve belirli bir sistemde çalışıp çalışamayacağını belirler. Ollama, LM Studio veya Llama.cpp gibi araçlarda yerel kullanım için GGUF formatı yerleşik hale gelmiştir. Kompakt, taşınabilir ve çeşitli platformlarda çıkarım için yüksek düzeyde optimize edilmiştir.
GGUF modelleri genellikle nicelenir, yani dahili sayısal değerler azaltılmış olarak saklanır, örneğin 4 bit veya 8 bit hassasiyetinde. Böylece başlangıçta 30 ila 50 GB olan modeller, yalnızca küçük bir kalite kaybıyla 5 ila 10 GB'a sıkıştırılabilir. Avantajı: GGUF, macOS'tan Windows'a ve Linux'a kadar hemen hemen her sistemde, özel bir GPU gerekmeden çalışır. Dezavantajı: Format eğitim veya ince ayar için değil, yalnızca saf kullanım için tasarlanmıştır.
GGUF'un yanında başka formatlar da vardır. MLX, Apple'ın Apple Silicon üzerinde makine öğrenimi için geliştirdiği kendi açık kaynak çerçevesidir. M çiplerindeki CPU, GPU ve Neural Engine'in tam performansını kullanmak için özel olarak geliştirilmiştir. MLX modelleri genellikle yerel MLX formatında bulunur veya diğer formatlardan dönüştürülür. Avantajı: Apple donanımında maksimum performans ve enerji verimliliği. Dezavantajı: Ekosistem henüz nispeten gençtir ve GGUF veya PyTorch'a kıyasla daha az topluluk modeli mevcuttur.
Safetensors, PyTorch dünyasından gelir ve Hugging Face tarafından güçlü şekilde desteklenir. Büyük modeller için kod yürütülmesine izin vermeyen güvenli, ikili bir depolama formatıdır – adı da buradan gelir: „güvenli“. Avantajı: Çok hızlı yüklenir, bellek tasarrufludur ve standartlaştırılmıştır. Dezavantajı: Esas olarak PyTorch veya TensorFlow gibi çerçeveler için tasarlanmıştır, yani daha çok geliştirici ortamlarında ve eğitim süreçlerinde yaygındır. Ollama veya MLX ile doğrudan kullanım için uyumlu değildir.
Niceleme basitçe anlatıldı: Yapay zeka neden daha az bellek gerektirir | bitgörüşü
Q4, Q8 ve FP16: En önemli seviyelerin karşılaştırması
Yaygın niceleme seviyeleri, doğrulukları ve bellek gereksinimleri açısından belirgin şekilde farklılık gösterir. Ollama varsayılan olarak 4 bit niceleme kullanır; bu, „q“ harfinden sonraki sayının niceleme için kullanılan bit sayısını gösterdiği anlamına gelir. Sayı ne kadar yüksekse model o kadar hassastır, ancak o kadar yavaş çalışır ve o kadar fazla bellek gerektirir. Daha yüksek niceleme seviyelerinde sorun yaşanıyorsa q4 modelini kullanmak veya çok fazla bellek tüketen programları kapatmak önerilir.
8 bit niceleme, kaliteyi etkilemeden maliyetleri düşürmenin basit bir yolunu sunar. Model boyutunun FP32'ye kıyasla yaklaşık dört kat azaltılmasıyla performans neredeyse aynı kalır ve doğruluk kaybı yüzde 1'in altındadır. Bu, nicelemeye yeni başlayan ekipler için mükemmel bir giriş seçeneği haline getirir ve düşük ila orta riskli bir seçenek sunar. 4 bit niceleme de üretim kullanımı için pratik bir seçenektir; 2 bit ise riskli kabul edilir.
Apple Silicon Mac'lerde yerel modeller çalıştıran geliştiriciler için nicemleme seviyesinin seçimi, bellek gereksinimi ile doğruluk arasında bir denge kurmaktır. 8-bit nicemleme bellek gereksinimini yüzde 50 azaltır, çıkarımı 1,8 kat hızlandırır ve HumanEval gibi zorlu kıyaslamalarda doğruluğun yüzde 99 oranından fazlasını korur. 4-bit nicemleme, 11 kat daha verimlidir; bu, 2-bit ile karşılaştırıldığında boyut küçültmenin kalite kaybına oranı açısından geçerlidir. Doğruluğun kritik olduğu uygulamalar için 8-bit nicemleme (INT8 veya FP8) neredeyse kayıpsız kalite sunar.
Yanıt kalitesi üzerindeki etki: Kalite kaybı nerede başlar?
Daha düşük niceleme seviyelerindeki kalite kaybı ölçülebilir ve model boyutuna bağlıdır. Ocak 2026„da yapılan bir kıyaslamada Q4_K_M (4 bit) yapılandırması, Mistral-7B-Instruct-v0.2“nin boyutunu 7,2 GB'tan 4,1 GB'a düşürdü – yüzde 43,1'lik bir azalma – kalite kaybı ise perplexity'de yalnızca yüzde 0,51 idi ve bu neredeyse ihmal edilebilir kabul edilir. Ancak 2 bit'e (Q2_K) daha fazla azaltma, yüzde 7,94'lik dik bir doğruluk kaybına yol açtı ve bu "kalite uçurumu" olarak adlandırılır.
70B varyantı kuantizasyona karşı daha hassastır. Llama 3.3 70B, MMLU kıyaslamasında 7,8 puanlık belirgin bir düşüş yaşadı; bu, model 4 bit'e düşürüldüğünde gerçekleşti. Bu gerileme, 8B sürümü gibi daha küçük modellerin dayanıklılığıyla tezat oluşturur. 2024 Ekim ayındaki performans değerlendirmeleri, 8 bit ile kuantize edilmiş modellerin tam hassasiyetli eşdeğerlerinin doğruluğunun yüzde 99,9 kadarını koruduğunu, 4 bit modellerin ise HumanEval+ gibi kıyaslamalarda yaklaşık yüzde 98,9 kadarını sürdürdüğünü gösteriyor.
Red Hat Developer yarım milyondan fazla değerlendirme gerçekleştirdi ve iyi kuantize edilmiş modellerin ortalama olarak temel puanın yüzde 99'ini geri kazandığını, tüm modellerin en az yüzde 96 geri kazanım sergilediğini tespit etti. Kuantize modellerin yanıt kalitesi, kuantize edilmemiş muadilleriyle yüksek düzeyde rekabetçi kalmaya devam ediyor. Yüzde 95 güven aralıkları tüm model boyutları ve kuantizasyon şemaları için örtüşüyor; bu da doğruluk üzerindeki asgari etkiyi vurguluyor.
Apple Silicon'da RAM tüketimi ve hız
Bir dil modeli yerel olarak çalıştığında, çalışma belleği (RAM veya Apple'da: „Unified Memory“) merkezi önem taşır. Ağırlıklar, aktivasyonlar ve ara sonuçlar dahil olmak üzere modelin kendisi bellekte tutulmalıdır. Model ne kadar büyükse, o kadar fazla bellek gerekir. Apple Silicon çipleri „Unified Memory“ kullanır; bu, CPU, GPU ve Neural Engine'in aynı bellek havuzuna eriştiği anlamına gelir. Böylece bileşenler arasındaki veri kopyalamaları ortadan kalkar, bu da verimliliği ve hızı artırır.
Yeterli RAM yoksa sistem takas yapmak zorunda kalır veya modeller tam olarak yüklenmez; bu da performans düşüşlerine, kararsızlığa veya iptale yol açabilir. Özellikle yanıt üretimi, metin girişi veya model genişletme gibi çıkarımsal uygulamalarda tepki süresi ve verim önemlidir ve burada yeterli bellek önemli ölçüde yardımcı olur. Geleneksel bir masaüstü bilgisayar eskiden „CPU RAM“ ve „ayrı GPU RAM“ olarak düşünürdü; Apple Silicon'da bu zarif bir şekilde birleştirilmiştir, bu da dil modellerini çalıştırmayı özellikle çekici kılar.
Birkaç milyar parametreli daha küçük modeller için, özellikle yalnızca tekli istekler işlenecekse 16 ila 32 GB RAM yeterli olabilir. 16/32 GB'lık bir Mac Mini bu nedenle bir giriş noktası olur. Yaklaşık 3 ila 10 milyar parametreli orta modeller veya birden fazla paralel sohbet ya da daha büyük metin miktarları içeren görevler için 32 GB RAM veya daha fazlası hedeflenmelidir; örneğin 32 veya 48 GB'lık Mac Studio. 20 milyar parametrenin üzerindeki büyük modeller veya birden fazla modelin paralel çalışması gerektiğinde 64 GB veya daha fazlası seçilebilir.
Yalnızca model değil, işletim sistemi, dosya G/Ç'si veya diğer uygulamalar gibi işletim de bellek rezervlerine ihtiyaç duyduğundan bir miktar tampon planlamak önemlidir. Küçük modeller (1-3 milyar parametre) için 16-32 GB RAM, orta modeller (7-13 milyar parametre) için 32-64 GB ve büyük modeller (30-70 milyar parametre) için 64 GB veya daha fazlası önerilir. Bu, qwen3-coder:30b gibi modellerin Q4_K_M'de 19 GB veya gpt-oss:20b'nin 16 GB RAM ile verimli şekilde çalıştırılmasını sağlar.
Pratik öneri: Hangi kullanım durumu için hangi seviye?
Uygun kuantizasyon seviyesinin seçimi doğrudan somut kullanım amacına ve veri koruma gereksinimlerine bağlıdır. Yerel dil modelleri özellikle gizliliğin zorunlu olduğu veya gerçek zamanlı süreçlerin talep edildiği yerlerde uygundur. Pratikte, avukatlık veya tıp gibi sektörlerin hassas hasta verilerini veya dilekçeleri bulut bağımlılığı olmadan işlemek için yerel çözümlere yöneldiği görülmektedir. Kitap ve medya üretiminde veya ERP sistemleri alanında da yerel modeller, doğrudan yazılımın içinden üretilen otomatik metin analizleri ve öneriler sağlar. Mühendislik büroları ve mimarlar için bu asistanlar ayrıca bir avantajdır, çünkü internet bağlantısı olmadan da güvenilir şekilde çalışırlar. Şirketler genel olarak tamamen kendi ağlarında kalan dahili sohbet asistanlarından ve tutanak değerlendirmelerinden yararlanır.
Yerel modellerin bulut hizmetlerine kıyasla önemli bir pratik avantajı tepki hızıdır. Harici API'ler ağ yolları veya sunucu yükü nedeniyle gecikebilirken, yerel modeller donanıma bağlı olarak neredeyse gerçek zamanlı yanıt verir. Bu, özellikle tekrarlanan görevlerde veya canlı veri analizi gibi etkileşimli süreçlerde iş akışı için belirleyicidir. Ticari alanda, kendi makinelerinde çalıştırma ayrıca modellerin şirkete özgü bilgilerle uyarlanmasını ve ince ayar yapılmasını sağlar. Böylece, kendi verileri üzerindeki egemenliği bırakmadan modern teknolojiyi kullanan bir BT altyapısı ortaya çıkar. Belirli bir kuantizasyon seviyesine karar vermek bu nedenle izole olarak ele alınmamalı, egemenlik ile performansı birleştiren bir stratejinin parçası olarak anlaşılmalıdır.
RAG sistemlerinde kuantizasyon: Özelliklere dikkat edin
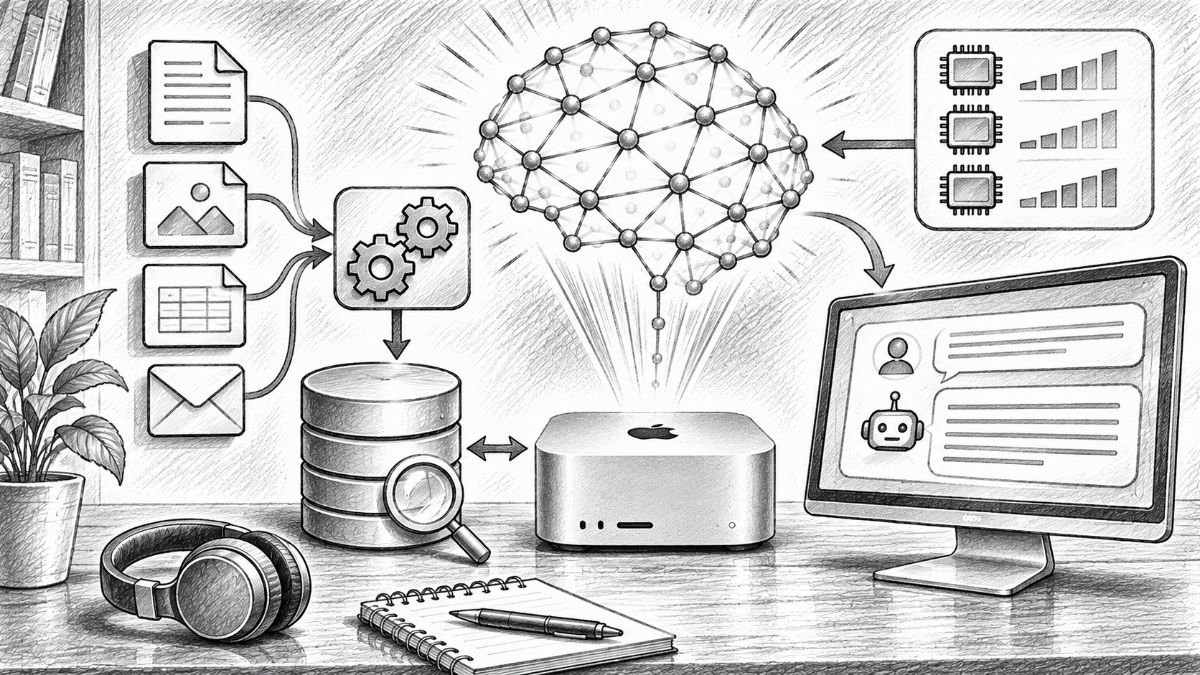
Retrieval-Augmented-Generation (RAG) sistemlerinde kuantizasyon merkezi bir rol oynar, çünkü burada dil modeli belge koleksiyonlarında veya veritabanlarında yapılan bir arama ile birleştirilir. Bu yöntem, üretilen yanıtların güvenilirliğini artırmaya ve modelin bilgi boşluklarını harici bilgiyle kapatmaya hizmet eder. RAG, özellikle bilgi yoğun senaryolarda yararlıdır, çünkü modelin ilgili, güncel olarak alınan bilgilere başvurmasını sağlayarak halüsinasyonları hafifletebilir. Böylece büyük dil modellerinin potansiyelleri, zahmetli ince ayarlar yapmadan dahili veriler için kullanılabilir.
Teknik uygulama, belgelerin önce daha küçük bölümlere ayrılmasını ve Ollama üzerinden vektör biçiminde (embedding) oluşturulmasını gerektirir. Bu vektörler daha sonra Qdrant gibi uygun bir veritabanına eklenir. Embedding süreci için kuantizasyon seviyesini seçerken, aşırı agresif sıkıştırmanın benzerlik hesaplamasını olumsuz etkileyebileceğine dikkat edilmelidir. Pratikte bu nedenle, düşük seviyelerin sağladığı bellek tasarrufunun arama doğruluğundaki potansiyel azalmayı haklı çıkarıp çıkarmadığı tartılmalıdır. Doğru bağlam parçalarının alınmasını sağlamak için embedding modellerinde üreten dil modelinin kendisinden daha yüksek bir hassasiyetin avantajlı olduğu sıklıkla görülür.
Kuantizasyon seviyesinin seçimi nihayetinde kaynak tüketimi ile doğruluk arasında bir uzlaşmadır. RAG sistemleri için, güvenilir sonuçlar elde etmek amacıyla arama hassasiyeti ile üreticinin performansını uyumlu hale getirmek gerekir.
LLM'lerin kuantizasyonu hakkında kaynaklar
- Apple MLX vs. NVIDIA: Mac'te yerel yapay zeka çıkarımı nasıl çalışır?
- Mac'te yerel yapay zeka: Ollama ile bir dil modeli nasıl kurulur
- Kendi verileri için evrensel bir arama motoru olarak Ollama ve Qdrant ile RAG
- llama2
- Kuantize LLM'leri test ettik: Maliyet ve performans sonuçları | Latitude
- Kuantize LLM'ler üzerinde yarım milyondan fazla değerlendirme yaptık—işte bulduklarımız | Red Hat Developer
- En İyi Ollama Modelleri 2026: VRAM ve SWE-Bench'e Göre 25+ Sıralama (Ekim 2026) | Morph
- Retrieval Augmented Generation (RAG): Kendi verilerinizle sohbet
- LLM'ler için Retrieval Augmented Generation (RAG) | Prompt Mühendisliği Rehberi
Yerel yapay zeka modellerinin kuantizasyonu hakkında sıkça sorulan sorular
Bir yapay zeka dil modelinde kuantizasyon ne anlama gelir?
Kuantizasyon, bir yapay zeka dil modelinin model ağırlıklarının sayısal hassasiyetinin azaltıldığı bir yöntemi ifade eder. Kuantize edilmemiş modeller genellikle 16-bit veya 32-bit kayan noktalı sayılarla çalışırken, kuantize edilmiş varyantlar örneğin ağırlık başına yalnızca 8, 4 veya hatta 2 bit kullanır. Bu, modelin temelden yeniden eğitilmesine gerek kalmadan gereken depolama alanını önemli ölçüde azaltır. Temel avantaj, daha büyük dil modellerinin de sınırlı bellek kapasitesine sahip bilgisayarlarda çalıştırılabilmesidir. Örneğin, orijinalinde ağırlıkları için yaklaşık 60 GB bellek gerektiren bir model, 4-bit kuantizasyon ile yaklaşık 15 ile 20 GB arasına indirilebilir. Gerçek boyut, kullanılan kuantizasyon yöntemine bağlıdır. Ancak dönüşüm sırasında bilgi kaybı yaşanır, bu nedenle yanıt kalitesi modele ve kullanım durumuna bağlı olarak farklı derecelerde etkilenebilir.
Q2, Q4, Q8 ve FP16 arasındaki fark nedir?
Q2, Q4, Q8 ve FP16 tanımları, model ağırlıklarının saklanmasındaki farklı hassasiyet seviyelerini açıklar. FP16, 16-bit kayan noktalı sayılar kullanır ve yüksek sayısal hassasiyet sunar, ancak bunun için nispeten fazla bellek gerektirir. Q8, ağırlıkları yaklaşık 8 bite indirir ve genellikle çok daha düşük bellek ihtiyacıyla neredeyse değişmemiş bir yanıt kalitesine ulaşır. Q4, ağırlık başına ağırlıklı olarak 4 bit kullanır ve bu nedenle birçok yerel uygulama için özellikle cazip bir denge sunar. Bellek tüketimi önemli ölçüde düşerken, kalite birçok modelde yüksek seviyede kalmaya devam eder. Q2 daha fazla sıkıştırır, ancak çok daha büyük kalite kayıplarına neden olabilir. Önemli olan, bu tanımların yalnızca temel hassasiyeti açıklamasıdır. Q4_K_M gibi kuantizasyon varyantları, özellikle önemli model ağırlıklarının hassasiyetini mümkün olduğunca iyi korumak için ek yöntemler kullanır.
Kuantizasyon ile gerçekte ne kadar bellek tasarrufu sağlanabilir?
Olası bellek tasarrufu; orijinal hassasiyete, model boyutuna ve seçilen kuantizasyon yöntemine bağlıdır. FP16'ya kıyasla, saf bir 8-bitlik temsil, model ağırlıkları için yaklaşık yarı yarıya daha az bellek gerektirir. 4 bitte ise bu teorik ihtiyaç yaklaşık dörtte birine düşer. Uygulamada, kuantizasyon için ek bilgilerin saklanması gerektiğinden modeller biraz daha büyük yer kaplar. 30 milyar parametreli bir dil modeli, FP16 formatında sadece ağırlıkları için yaklaşık 60 GB gerektirir. Bir 8-bitlik varyant yaklaşık 30 GB gerektirirken, bir 4-bitlik sürüm genellikle yaklaşık 18 ile 20 GB arasındadır. Ancak bu değerler kullanım sırasındaki toplam bellek ihtiyacını tanımlamaz. Ek olarak bağlam belleği, geçici hesaplamalar ve işletim sistemi gibi unsurlar da dikkate alınmalıdır. Bu nedenle, bir model seçerken her zaman yeterli bir bellek rezervi planlanmalıdır.
Q4 kuantizasyonu bir dil modelinin yanıt kalitesini ne kadar kötüleştirir?
Birçok modern dil modelinde, yüksek kaliteli bir 4-bit kuantizasyonu yalnızca nispeten düşük kalite kayıplarına neden olur. Özellikle metin özetleme, çeviri, basit programlama görevleri veya genel bilgi soruları gibi günlük görevlerde, daha yüksek hassasiyetli varyantlarla olan farklar genellikle neredeyse fark edilemez. Ancak gerçek kalite, ilgili modele ve göreve bağlı olarak büyük ölçüde değişir. Karmaşık matematiksel hesaplamalar, zorlu programlama görevleri veya çok aşamalı mantıksal çıkarımlarda küçük sayısal sapmalar daha büyük etkilere yol açabilir. Seçilen kuantizasyon yöntemi de bir rol oynar. Q4_K_M gibi yöntemler, özellikle hassas model alanlarını daha yüksek hassasiyetle korumaya çalışır. Bu nedenle birçok kullanıcı için Q4 mantıklı bir başlangıç noktasıdır. Özellikle güvenilir sonuçlara ihtiyaç duyanlar, aynı modeli ek olarak Q8 formatında test etmeli ve yanıtları tipik görevler üzerinden karşılaştırmalıdır.
Daha küçük bir Q4 versiyonu yerine Q8 veya FP16 ne zaman mantıklıdır?
Yüksek hassasiyet, özellikle bir dil modelinin zorlu görevleri yerine getirmesi gerektiğinde ve yeterli bellek mevcut olduğunda mantıklı olabilir. Buna örneğin karmaşık yazılım geliştirme, bilimsel değerlendirmeler, matematiksel hesaplamalar veya birbirini takip eden birden fazla düşünce adımı içeren kapsamlı analizler dahildir. Q8 bu noktada genellikle iyi bir orta yol sunar. Model ağırlıkları, benzer bir 4-bit kuantizasyonuna göre yaklaşık iki kat daha fazla bellek gerektirir, ancak kalite genellikle daha yüksek hassasiyetli orijinal versiyona çok yakındır. FP16 ise, maksimum sayısal hassasiyet gerektiğinde ve donanım önemli bellek ihtiyacını karşılayabildiğinde tercih edilir. Ancak FP16 de hatasız yanıtlar için bir garanti sunmaz. Birçok pratik uygulama için, Q4 formatındaki daha güçlü bir model, FP16 formatındaki çok daha küçük bir modelden daha iyi bir seçim olabilir.
2-bit kuantize edilmiş yapay zeka modelleri neden sorunlu olabilir?
Bir 2-bit kuantizasyonunda, model ağırlıklarının gösterimi için 4 veya 8 bit değerlerine kıyasla önemli ölçüde daha az basamak mevcuttudur. Bu sayede dil modelleri çok güçlü bir şekilde sıkıştırılabilse de, sinir ağı içindeki bağlantılar hakkındaki önemli bilgiler kaybolabilir. Bu kayıplar her zaman basit sorularda kendini göstermez. Zorluklar genellikle hassas hesaplamalar, uzun düşünce süreçleri veya kapsamlı bilgilerin güvenilir işlenmesini gerektiren daha karmaşık görevlerde ortaya çıkar. Yanıtlar daha az doğru, çelişkili veya daha az istikrarlı hale gelebilir. Özellikle sorunlu olan durum, bu tür kalite kayıplarının her zaman bariz olmamasıdır. Bir model, sonuçları maddi hatalar içerse bile hala ikna edici bir şekilde ifade yapabilir. Bu nedenle Q2, yalnızca deneysel uygulamalar veya çok sınırlı belleğe sahip durumlar için uygundur. Zorlu üretim sistemleri için Q4 ve Q8 genellikle daha güvenilir bir temel oluşturur.
GGUF, MLX ve Safetensors arasında ne gibi farklar vardır?
GGUF, MLX ve Safetensors yerel yapay zeka modelleriyle ilgili olarak sıkça anılır, ancak farklı görevleri yerine getirirler. GGUF, özellikle llama.cpp, Ollama ve LM Studio ortamlarında yaygın olan bir model formatıdır. Çeşitli kuantizasyon yöntemlerini destekler ve dil modellerinin farklı donanım platformlarında çalıştırılmasına olanak tanır. MLX ise Apple tarafından geliştirilen ve özellikle Apple Silicon mimarisine odaklanmış bir makine öğrenmesi çerçevesidir (framework). MLX ile dil modelleri, M işlemcili Mac'lerde verimli bir şekilde çalıştırılabilir. Bunun için özel olarak kuantize edilmiş model varyantları da mevcuttur. Safetensors ise sayısal model ağırlıklarını depolamak için güvenli bir dosya formatıdır. Genellikle Hugging Face ve PyTorch ortamlarında kullanılır. Dolayısıyla format seçimi, kullanılan çalışma ortamına bağlıdır. Apple Silicon Mac'lerde hem GGUF hem de MLX modelleri mantıklı olabilir, ancak hızları modele ve uygulamaya göre değişiklik gösterir.
Kuantize edilmiş yapay zeka modelleri otomatik olarak daha mı hızlı olur?
Her zaman değil. Kuantizasyon öncelikle bir modelin bellek ihtiyacını azaltır. Bu sayede işlem sırasında bellekten genellikle daha az veri okunması gerekir, bu da özellikle bellek bant genişliğine bağlı hesaplamalarda önemli avantajlar sağlayabilir. Apple Silicon Mac'lerde bu etki, CPU ve GPU ortak bir bellek havuzuna eriştiği için özellikle ilgi çekicidir. Daha küçük model ağırlıkları daha verimli bir şekilde aktarılabilir ve işlenebilir. Bu nedenle kuantize edilmiş modeller birçok durumda metin oluşturmada daha yüksek hız elde eder. Ancak, kuantize edilmiş ağırlıkların işlenmesi, uygun sayısal değerleri geri kazanmak için bazen ek hesaplama işlemleri gerektirebilir. Hangi varyantın gerçekten daha hızlı olduğu; donanıma, kullanılan yazılıma ve somut kuantizasyon yöntemine bağlıdır. Sadece saniye başına token cinsinden saf hızın değil, ilk yanıt süresinin de dikkate alınması gerekir. Özellikle etkileşimli uygulamalarda hızlı bir tepki süresi, maksimum üretim performansından daha önemli olabilir.
16, 32, 64 veya 128 GB bellek kapasitesine sahip Mac'ler için hangi kuantizasyon seviyesi uygundur?
Uygun kuantizasyon, hem mevcut bellek kapasitesine hem de istenen dil modelinin boyutuna bağlıdır. 16 GB Birleşik Bellek (Unified Memory) kapasiteli Mac'lerde, özellikle birkaç milyar parametreli daha küçük modeller uygundur. İşletim sistemi ve bağlam (context) için yeterli bellek kaldığı sürece, Q4 kuantizasyonu ile tekil büyük modeller bile kullanılabilir hale gelebilir. 32 GB bellek ile 7B ile 14B sınıfındaki çok sayıda model rahatlıkla çalıştırılabilir. Ayrıca daha büyük, yüksek oranda kuantize edilmiş modeller de kısmen mümkündür. 64 GB ile 30 milyar parametreli modeller veya daha kapsamlı bağlam pencereleri için çok daha fazla seçenek mevcuttur. 128 GB Birleşik Bellek sunan Mac'ler ise özellikle çok büyük modeller, daha yüksek hassasiyet seviyeleri ve birden fazla yapay zeka bileşeninin paralel çalıştırılması için alan sağlar. Belirleyici olan gerçek model boyutudur. Parametre sayısı, kuantizasyon, bağlam uzunluğu ve model mimarisi her zaman birlikte değerlendirilmelidir.
Bir yapay zeka modeli, Mac'in sağlayabileceğinden daha fazla bellek gerektirirse ne olur?
Bir dil modeli çok fazla bellek gerektirirse, macOS verilerin bir kısmını SSD'ye aktarmaya (swap) çalışabilir. Bu 'swapping' işlemi belirli koşullarda programın anında kapanmasını engeller, ancak bellek yoğunluklu yapay zeka uygulamalarında genellikle önemli performans kayıplarına yol açar. Bunun nedeni, hızlı SSD'lerin bile dahili bellekten (RAM) çok daha düşük bir veri aktarım hızına sahip olmasıdır. Metin oluşturma sırasında sürekli SSD ve RAM arasında geçiş yapılması gerekiyorsa, yanıt hızı ciddi şekilde düşebilir. Ayrıca macOS, Birleşik Belleğin tamamını kısıtlamasız bir şekilde yapay zeka uygulamalarına sunmaz. İşletim sistemi, grafik arayüzü ve diğer programlar da belleğe ihtiyaç duyar. Bu tür sorunlardan kaçınmak isteyenler, önce kullanılmayan uygulamaları kapatmalı, bağlam uzunluğunu azaltmalı veya daha güçlü kuantize edilmiş bir model varyantı kullanmalıdır. Özellikle büyük dil modellerinde, istikrarlı ve akıcı bir çalışma için yeterli bellek rezervi hayati önem taşır.
11. RAG sistemlerinde ve kendi belgelerin işlenmesinde kuantizasyonun rolü nedir?
Retrieval-Augmented Generation (RAG) işleminde dil modelleri harici bir bilgi kaynağı ile birleştirilir. Belgeler önce daha küçük bölümlere ayrılır ve bir embedding modeli kullanılarak sayısal vektörlere dönüştürülür. Bir vektör veritabanı, ardından içerik olarak uygun belge bölümlerinin aranmasına olanak tanır. Kuantizasyon bu süreçte farklı noktalarda kullanılabilir. Örneğin, bellekten tasarruf etmek için üreten dil modeli Q4 ile çalıştırılabilir. Buna karşılık, embedding modeli ve vektörlerin saklanması sırasında, benzerlik aramasının kalitesinin korunmasına özellikle dikkat edilmelidir. Çok agresif bir sıkıştırma, ilgili belge bölümlerinin daha kötü bulunmasına neden olabilir. Bu durumda güçlü bir dil modeli bile doğru bir yanıt için ihtiyaç duyduğu bilgileri alamayabilir. Bu nedenle RAG sistemlerinde hem belge arama kalitesi hem de dil modelinin yanıt kalitesi ayrı ayrı kontrol edilmelidir.
12. Yerel yapay zeka sistemim için en uygun kuantizasyonu nasıl bulabilirim?
En iyi kuantizasyon sadece model boyutu veya bir benchmark tablosuna bakarak belirlenemez. Belirleyici olan, dil modelinin pratik kullanımda hangi görevleri yerine getirmesi gerektiği ve bunun için hangi donanımın mevcut olduğudur. Mantıklı bir başlangıç, öncelikle istenen modelin yüksek kaliteli bir Q4 varyantını kurmaktır. Ardından, metin özetleme, programlama görevleri, çeviriler veya kendi belgelerinin analizi gibi tipik görevler gerçekleştirilmelidir. Bu süreçte yanıt kalitesi, hız, bellek kullanımı ve güvenilirliğin gözlemlenmesi tavsiye edilir. Eğer yeterli bellek varsa, aynı model ek olarak Q8 formatında da test edilebilir. Sonuçlar ardından doğrudan karşılaştırılabilir. Her iki varyant için mümkün olduğunca özdeş test koşullarını kullanmak önemlidir. Farklar ancak bu şekilde gerçekten fark edilebilir. Nihayetinde belirleyici olan en yüksek hassasiyet değil, yeterli kalite, iyi hız ve mevcut donanım üzerinde istikrarlı yürütmenin kombinasyonudur.