
Quien ejecuta modelos de IA locales con Ollama, LM Studio u otras aplicaciones en Macs con Apple Silicon se enfrenta antes o después a una pregunta decisiva: ¿hasta qué punto se puede comprimir un modelo de lenguaje sin que sufra la calidad de sus respuestas? Los modelos de IA modernos necesitan a veces cantidades enormes de memoria de trabajo. Mediante la llamada cuantización, esta necesidad se puede reducir considerablemente, de modo que incluso modelos potentes puedan ejecutarse en hardware comparativamente asequible. Sin embargo, no todos los niveles de compresión son igualmente adecuados para tareas exigentes.
Entre Q2, Q4, Q8 y FP16 existen diferencias claras en cuanto a consumo de memoria, velocidad y precisión. Especialmente en análisis complejos, tareas de programación o el procesamiento de documentos propios, estas diferencias pueden ser decisivas. Este artículo explica los fundamentos técnicos de la cuantización, compara formatos habituales como GGUF y MLX y muestra qué efectos tienen los distintos niveles de precisión en los sistemas de IA locales. Recomendaciones prácticas ayudan a encontrar un compromiso sensato entre rendimiento, consumo de memoria y calidad de respuesta para el propio hardware y el uso previsto.

Qué significa la cuantización en los modelos locales
Los modelos de lenguaje no solo se diferencian por sus capacidades, sino también por el formato técnico en el que se presentan. Estos formatos determinan cómo se almacena, carga y utiliza un modelo, y si es ejecutable en un sistema determinado. Para el uso local en herramientas como Ollama, LM Studio o Llama.cpp, se ha establecido el formato GGUF. Es compacto, portátil y está altamente optimizado para la inferencia en distintas plataformas.
Los modelos GGUF suelen estar cuantizados, lo que significa que los valores numéricos internos se almacenan de forma reducida, por ejemplo con precisión de 4 bits o 8 bits. Así, modelos que originalmente ocupaban de 30 a 50 GB pueden comprimirse a entre 5 y 10 GB, con solo una ligera pérdida de calidad. La ventaja: GGUF funciona en casi cualquier sistema, desde macOS hasta Windows y Linux, sin necesidad de una GPU especial. La desventaja: el formato no está pensado para entrenamiento ni ajuste fino, sino únicamente para el uso directo.
Además de GGUF, existen otros formatos. MLX es el propio framework de código abierto de Apple para machine learning en Apple Silicon. Se desarrolló específicamente para aprovechar al máximo el rendimiento de la CPU, la GPU y la Neural Engine de los chips M. Los modelos MLX suelen estar en el formato nativo MLX o se convierten desde otros formatos. La ventaja: máximo rendimiento y eficiencia energética en hardware de Apple. La desventaja: el ecosistema aún es relativamente joven y hay menos modelos de la comunidad disponibles que en GGUF o PyTorch.
Safetensors proviene del mundo de PyTorch y cuenta con un fuerte impulso de Hugging Face. Es un formato de almacenamiento binario seguro para modelos grandes que no permite la ejecución de código, de ahí el nombre „safe“. La ventaja: se carga muy rápido, ahorra memoria y está estandarizado. La desventaja: está pensado principalmente para frameworks como PyTorch o TensorFlow, por lo que es más habitual en entornos de desarrollo y procesos de entrenamiento. No es compatible para el uso directo con Ollama o MLX.
Cuantización explicada de forma sencilla: por qué la IA necesita menos memoria | vista de bits
Q4, Q8 y FP16: los niveles más importantes en comparación
Los niveles de cuantización habituales difieren claramente en precisión y consumo de memoria. Ollama utiliza por defecto cuantización de 4 bits, lo que significa que el número después de la „q“ indica la cantidad de bits utilizados para la cuantización. Cuanto mayor sea el número, más preciso es el modelo, pero más lento se ejecuta y más memoria necesita. Si hay problemas con niveles de cuantización más altos, se recomienda usar el modelo q4 o cerrar programas que consuman mucha memoria.
La cuantización de 8 bits ofrece una forma sencilla de reducir costes sin afectar la calidad. Al reducir el tamaño del modelo aproximadamente a la cuarta parte en comparación con FP32, el rendimiento se mantiene casi igual, con una pérdida de precisión de menos del 1 por ciento. Esto la convierte en una excelente opción inicial para equipos que se inician en la cuantización y ofrece una opción de riesgo bajo a moderado. La cuantización de 4 bits también es una opción práctica para uso en producción, mientras que la de 2 bits se considera arriesgada.
Para desarrolladoras y desarrolladores que ejecutan modelos locales en Macs con Apple Silicon, la elección del nivel de cuantización es un equilibrio entre consumo de memoria y precisión. La cuantización de 8 bits reduce el consumo de memoria en un 50 por ciento, acelera la inferencia 1,8 veces y mantiene más del 99 por ciento de la precisión en benchmarks exigentes como HumanEval. La cuantización de 4 bits es 11 veces más eficiente que la de 2 bits en cuanto a reducción de tamaño en relación con la pérdida de calidad. Para aplicaciones en las que la precisión es decisiva, la cuantización de 8 bits (INT8 o FP8) ofrece una calidad casi sin pérdidas.
El impacto en la calidad de las respuestas: ¿dónde comienza la pérdida de calidad?
La pérdida de calidad en niveles de cuantización más bajos es medible y depende del tamaño del modelo. En un benchmark de enero de 2026, la configuración Q4_K_M (4 bits) redujo el tamaño de Mistral-7B-Instruct-v0.2 de 7,2 GB a 4,1 GB, una reducción del 43,1 por ciento, mientras que la pérdida de calidad en perplexity fue de solo 0,51 por ciento, considerada casi insignificante. Una reducción adicional a 2 bits (Q2_K) provocó, sin embargo, una fuerte pérdida de precisión del 7,94 por ciento, lo que se denomina „acantilado de calidad“.
La variante de 70B es más sensible a la cuantización. Llama 3.3 70B sufrió una caída perceptible de 7,8 puntos en el benchmark MMLU cuando se redujo a 4 bits. Esta reducción contrasta con la robustez de modelos más pequeños como la versión de 8B. Las evaluaciones de rendimiento de octubre de 2024 muestran que los modelos cuantizados a 8 bits conservan el 99,9 por ciento de la precisión de sus equivalentes de precisión completa, mientras que los modelos de 4 bits mantienen aproximadamente el 98,9 por ciento en benchmarks como HumanEval+.
Red Hat Developer realizó más de medio millón de evaluaciones y concluyó que los modelos bien cuantizados recuperan, en promedio, el 99 por ciento de la puntuación de referencia, y todos los modelos muestran al menos un 96 por ciento de recuperación. La calidad de respuesta de los modelos cuantizados sigue siendo muy competitiva frente a sus equivalentes no cuantizados. Los intervalos de confianza del 95 por ciento se solapan para todos los tamaños de modelo y esquemas de cuantización, lo que subraya el impacto mínimo en la precisión.
Consumo de RAM y velocidad en Apple Silicon
Si un modelo de lenguaje se ejecuta localmente, la memoria de trabajo (RAM o, en Apple, „Unified Memory“) es de importancia central. El modelo en sí, incluidos pesos, activaciones y resultados intermedios, debe mantenerse en memoria. Cuanto mayor sea el modelo, más memoria se necesita. Los chips Apple Silicon utilizan „Unified Memory“, lo que significa que la CPU, la GPU y la Neural Engine acceden al mismo pool de memoria. Así se evitan copias de datos entre componentes, lo que aumenta la eficiencia y la velocidad.
Si no hay suficiente RAM, el sistema debe paginar o los modelos no se cargan completamente, lo que puede provocar caídas de rendimiento, inestabilidad o interrupciones. Especialmente en aplicaciones inferenciales, como generación de respuestas, entrada de texto o ampliación de modelos, importan el tiempo de respuesta y el rendimiento, y aquí la memoria suficiente ayuda considerablemente. Un PC de escritorio tradicional pensaba antes en „RAM de CPU“ y „RAM de GPU separada“; en Apple Silicon está elegantemente unificado, lo que hace especialmente atractivo ejecutar modelos de lenguaje.
Para modelos más pequeños, por ejemplo con unos pocos miles de millones de parámetros, podrían bastar 16 a 32 GB de RAM, sobre todo si solo se van a procesar solicitudes individuales. Un Mac Mini con 16/32 GB sería, por tanto, un punto de partida. Para modelos medianos, por ejemplo con 3 a 10 mil millones de parámetros, o tareas con varios chats en paralelo o mayores cantidades de texto, conviene tener en cuenta 32 GB de RAM o más, p. ej., Mac Studio con 32 o 48 GB. Para modelos grandes, de más de 20 mil millones de parámetros, o si deben ejecutarse varios modelos en paralelo, se podrían elegir 64 GB o más.
Es importante planificar un margen, ya que no solo el modelo, sino también el funcionamiento, como el sistema operativo, la E/S de archivos u otras aplicaciones, necesita reservas de memoria. Para modelos pequeños (1-3 mil millones de parámetros) se recomiendan 16-32 GB de RAM, para modelos medianos (7-13 mil millones de parámetros) 32-64 GB, y para modelos grandes (30-70 mil millones de parámetros) 64 GB o más. Esto permite operar de forma eficiente modelos como qwen3-coder:30b con 19 GB en Q4_K_M o gpt-oss:20b con 16 GB de RAM.
Recomendación práctica: ¿qué nivel para qué caso de uso?
La elección del nivel de cuantización adecuado depende directamente del caso de uso concreto y de los requisitos de protección de datos. Los modelos de lenguaje locales son especialmente adecuados donde la confidencialidad es obligatoria o se requieren procesos en tiempo real. En la práctica se observa que sectores como la abogacía o la medicina recurren a soluciones locales para procesar datos sensibles de pacientes o escritos sin dependencia de la nube. También en la producción de libros y medios o en el ámbito de los sistemas ERP, los modelos locales permiten análisis de texto automáticos y sugerencias que se generan directamente desde el software. Para oficinas de ingeniería y arquitectos, estos asistentes son además una ventaja, ya que funcionan de forma fiable incluso sin conexión a internet. En general, las empresas se benefician de asistentes de chat internos y evaluaciones de protocolos que permanecen completamente dentro de su propia red.
Una ventaja práctica esencial de los modelos locales frente a los servicios en la nube es la velocidad de respuesta. Mientras que las API externas pueden verse retrasadas por rutas de red o carga del servidor, los modelos locales responden casi en tiempo real según el hardware. Esto es decisivo para el flujo de trabajo, especialmente en tareas repetitivas o procesos interactivos, como un análisis de datos en vivo. En el ámbito comercial, el funcionamiento en máquinas propias permite además la adaptación y el ajuste fino de los modelos con conocimiento propio de la empresa. Así surge un panorama de TI que utiliza tecnología moderna sin ceder la soberanía sobre los propios datos. Por lo tanto, la decisión por un nivel de cuantización determinado no debe considerarse de forma aislada, sino entenderse como parte de una estrategia que une soberanía y capacidad de rendimiento.
Cuantización en sistemas RAG: tener en cuenta particularidades
En los sistemas de generación aumentada por recuperación (RAG), la cuantización desempeña un papel central, ya que aquí el modelo de lenguaje se combina con una búsqueda en colecciones de documentos o bases de datos. Este procedimiento sirve para aumentar la fiabilidad de las respuestas generadas y para cerrar lagunas de conocimiento del modelo mediante conocimiento externo. RAG es especialmente útil en escenarios intensivos en conocimiento, ya que puede mitigar las alucinaciones al recurrir el modelo a información relevante y recién recuperada. Así se pueden aprovechar las capacidades de los grandes modelos de lenguaje para datos internos sin necesidad de realizar ajustes finos costosos.
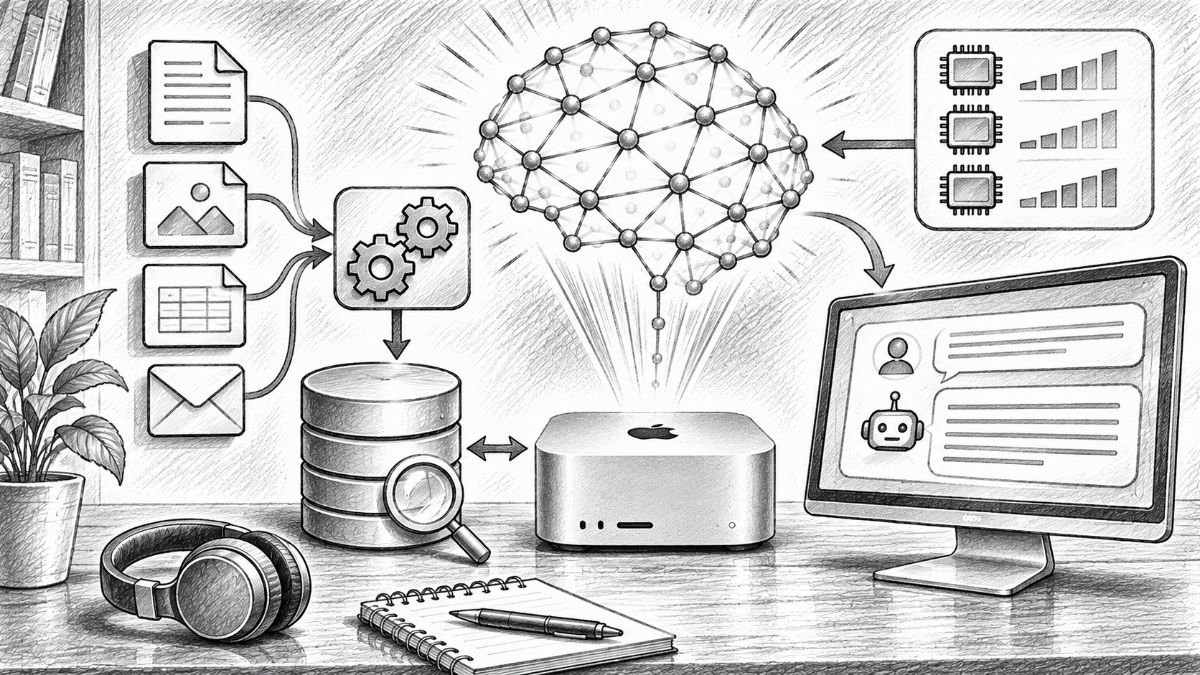
La implementación técnica requiere que los documentos se dividan primero en secciones más pequeñas y se generen en forma vectorial (embeddings) mediante Ollama. Estos vectores se insertan después en una base de datos adecuada, como Qdrant. Al elegir el nivel de cuantización para el proceso de embedding, hay que tener en cuenta que una compresión demasiado agresiva puede afectar al cálculo de similitud. En la práctica, por tanto, debe valorarse si el ahorro de memoria mediante niveles más bajos justifica la posible reducción de la precisión de búsqueda. A menudo se observa que para los modelos de embedding es ventajosa una mayor precisión que para el propio modelo de lenguaje generador, para garantizar que se recuperen los fragmentos de contexto correctos.
La elección del nivel de cuantización es, en última instancia, un compromiso entre consumo de recursos y precisión. Para los sistemas RAG, se trata de poner en equilibrio la precisión de la búsqueda y el rendimiento del generador para obtener resultados fiables.
Fuentes sobre cuantización de LLM
- Apple MLX frente a NVIDIA: cómo funciona la inferencia local de IA en el Mac
- IA local en el Mac: cómo instalar un modelo de lenguaje con Ollama
- RAG con Ollama y Qdrant como motor de búsqueda universal de datos propios
- llama2
- Probamos LLM cuantizados: resultados de coste y rendimiento | Latitude
- Ejecutamos más de medio millón de evaluaciones sobre LLM cuantizados: esto es lo que encontramos | Red Hat Developer
- Mejores modelos de Ollama 2026: 25+ clasificados por VRAM y SWE-Bench (octubre 2026) | Morph
- Generación aumentada por recuperación (RAG): chat con datos propios
- Generación aumentada por recuperación (RAG) para LLM | Guía de ingeniería de prompts

Preguntas frecuentes sobre la cuantización de modelos de IA locales
¿Qué significa cuantización en un modelo de lenguaje de IA?
La cuantización designa un procedimiento en el que se reduce la precisión numérica de los pesos de un modelo de lenguaje de IA. Mientras que los modelos no cuantizados suelen trabajar con números de coma flotante de 16 bits o 32 bits, las variantes cuantizadas utilizan, por ejemplo, solo 8, 4 o incluso 2 bits por peso. Así, el espacio de almacenamiento necesario se reduce considerablemente, sin que el modelo tenga que volver a entrenarse desde cero. La ventaja decisiva consiste en que también se pueden ejecutar modelos de lenguaje más grandes en ordenadores con memoria de trabajo limitada. Por ejemplo, un modelo que originalmente necesitaba alrededor de 60 GB de memoria para sus pesos puede reducirse mediante cuantización de 4 bits a aproximadamente 15 a 20 GB. El tamaño real depende del procedimiento de cuantización utilizado. Sin embargo, en la conversión se pierde información, por lo que la calidad de las respuestas puede verse afectada en mayor o menor medida según el modelo y el caso de uso.
¿Cuál es la diferencia entre Q2, Q4, Q8 y FP16?
Las denominaciones Q2, Q4, Q8 y FP16 describen distintos niveles de precisión en el almacenamiento de los pesos del modelo. FP16 utiliza números de coma flotante de 16 bits y ofrece una alta precisión numérica, aunque necesita comparativamente mucha memoria de trabajo. Q8 reduce los pesos a aproximadamente 8 bits y suele alcanzar una calidad de respuesta casi inalterada con un consumo de memoria notablemente menor. Q4 utiliza predominantemente 4 bits por peso y, por eso, representa para muchas aplicaciones locales un compromiso especialmente atractivo. El consumo de memoria disminuye considerablemente, mientras que la calidad se mantiene en muchos modelos a un nivel alto. Q2 comprime aún más, pero puede causar pérdidas de calidad notablemente mayores. Es importante que estas denominaciones solo describen la precisión básica. Variantes de cuantización como Q4_K_M utilizan procedimientos adicionales para conservar lo mejor posible la precisión de los pesos del modelo especialmente importantes.
¿Cuánta memoria de trabajo se puede ahorrar realmente mediante la cuantización?
La posible reducción de memoria depende de la precisión original, del tamaño del modelo y del procedimiento de cuantización elegido. Frente a FP16, una representación pura de 8 bits necesita aproximadamente la mitad de memoria para los pesos del modelo. Con 4 bits, esta necesidad teórica se reduce a aproximadamente una cuarta parte. En la práctica, los modelos resultan algo más grandes, porque deben almacenarse informaciones adicionales para la cuantización. Un modelo de lenguaje con 30 mil millones de parámetros necesita en FP16 solo para sus pesos aproximadamente 60 GB. Una variante de 8 bits necesita alrededor de 30 GB, mientras que una versión de 4 bits suele situarse en aproximadamente 18 a 20 GB. Sin embargo, estos valores no describen todo el consumo de memoria de trabajo durante el uso. Además deben tenerse en cuenta, entre otros, la memoria de contexto, los cálculos temporales y el sistema operativo. Por eso, al elegir un modelo siempre debe planificarse una reserva de memoria suficiente.
¿En qué medida empeora la calidad de respuesta de un modelo de lenguaje la cuantización Q4?
En muchos modelos de lenguaje modernos, una cuantización de alta calidad de 4 bits causa solo pérdidas de calidad comparativamente pequeñas. Especialmente en tareas cotidianas como resúmenes de texto, traducciones, tareas sencillas de programación o preguntas generales de conocimiento, las diferencias respecto a variantes de mayor precisión suelen ser apenas perceptibles. No obstante, la calidad real depende mucho del modelo y de la tarea. En cálculos matemáticos complejos, tareas de programación exigentes o razonamientos lógicos de varios pasos, pequeñas desviaciones numéricas pueden tener efectos mayores. También influye el método de cuantización elegido. Procedimientos como Q4_K_M intentan conservar con mayor precisión las áreas del modelo especialmente sensibles. Para muchos usuarios, Q4 es por eso un punto de partida razonable. Quien necesite resultados especialmente fiables debería probar además el mismo modelo en Q8 y comparar las respuestas con tareas típicas.
¿Cuándo tiene sentido usar Q8 o FP16 en lugar de una versión Q4 más pequeña?
Una mayor precisión puede ser especialmente útil cuando un modelo de lenguaje debe realizar tareas exigentes y hay suficiente memoria de trabajo disponible. Entre ellas se incluyen, por ejemplo, el desarrollo de software complejo, evaluaciones científicas, cálculos matemáticos o análisis extensos con varios pasos de razonamiento consecutivos. Q8 ofrece a menudo un buen término medio. Los pesos del modelo necesitan aproximadamente el doble de memoria que en una cuantización comparable de 4 bits, pero la calidad suele estar muy cerca de la versión original de mayor precisión. FP16 entra en consideración sobre todo cuando se necesita la máxima precisión numérica y el hardware puede soportar el considerable consumo de memoria. Sin embargo, ni siquiera FP16 garantiza respuestas sin errores. Para muchas aplicaciones prácticas, un modelo más potente en Q4 puede ser la mejor opción frente a un modelo notablemente más pequeño en FP16.
¿Por qué pueden ser problemáticos los modelos de IA cuantizados a 2 bits?
En una cuantización de 2 bits hay disponibles para representar los pesos del modelo considerablemente menos niveles que con 4 o 8 bits. Así, los modelos de lenguaje pueden comprimirse de forma especialmente fuerte, pero pueden perderse informaciones importantes sobre las relaciones dentro de la red neuronal. Estas pérdidas no se manifiestan necesariamente en preguntas sencillas. Las dificultades suelen aparecer solo en tareas más complejas que requieren cálculos precisos, cadenas de pensamiento más largas o el procesamiento fiable de informaciones extensas. Las respuestas pueden volverse entonces menos precisas, contradictorias o menos estables. Especialmente problemático es que tales pérdidas de calidad no siempre son evidentes. Un modelo puede seguir formulando de forma convincente, aunque sus resultados contengan errores de contenido. Por eso, Q2 se adapta sobre todo a aplicaciones experimentales o a situaciones con memoria muy limitada. Para sistemas productivos exigentes, Q4 y Q8 suelen ser la base más fiable.
¿Qué diferencias existen entre GGUF, MLX y Safetensors?
GGUF, MLX y Safetensors se mencionan con frecuencia en relación con los modelos de IA locales, pero cumplen funciones distintas. GGUF es un formato de modelo muy extendido en el entorno de llama.cpp, Ollama y LM Studio. Admite varios procedimientos de cuantización y permite ejecutar modelos de lenguaje en distintas plataformas de hardware. MLX, en cambio, es un framework de aprendizaje automático desarrollado por Apple, orientado específicamente a la arquitectura de Apple Silicon. Con MLX se pueden ejecutar modelos de lenguaje de forma eficiente en Macs con procesadores M. Para ello también hay variantes de modelo cuantizadas específicamente. Safetensors es un formato de archivo seguro para almacenar pesos numéricos de modelos. Se utiliza con frecuencia en el entorno de Hugging Face y PyTorch. La elección del formato depende, por tanto, del entorno de ejecución utilizado. En los Mac con Apple Silicon pueden tener sentido tanto los modelos GGUF como los MLX, aunque su velocidad varía según el modelo y la implementación.
¿Los modelos de IA cuantizados se vuelven automáticamente más rápidos?
No necesariamente. La cuantización reduce primero el consumo de memoria de un modelo. Así, durante el procesamiento a menudo hay que leer menos datos de la memoria de trabajo, lo que puede aportar ventajas considerables, especialmente en cálculos dependientes del ancho de banda de memoria. En los Mac con Apple Silicon este efecto es especialmente interesante, porque la CPU y la GPU acceden a un pool de memoria compartido. Los pesos de modelo más pequeños se pueden transferir y procesar de forma más eficiente. Por eso, en muchos casos los modelos cuantizados alcanzan una mayor velocidad en la generación de texto. Sin embargo, el procesamiento de pesos cuantizados requiere a veces operaciones de cálculo adicionales para recuperar valores numéricos adecuados. Por lo tanto, qué variante es realmente más rápida depende del hardware, del software utilizado y del procedimiento de cuantización concreto. Además de la velocidad pura en tokens por segundo, también debe tenerse en cuenta el tiempo hasta la primera respuesta. En aplicaciones interactivas, un tiempo de reacción rápido puede ser más importante que el rendimiento máximo de generación.
¿Qué nivel de cuantización es adecuado para Macs con 16, 32, 64 o 128 GB de memoria de trabajo?
La cuantización adecuada depende tanto de la capacidad de memoria disponible como del tamaño del modelo de lenguaje deseado. En Macs con 16 GB de memoria unificada, son especialmente adecuados los modelos más pequeños con pocos miles de millones de parámetros. Mediante la cuantización Q4, también pueden utilizarse algunos modelos más grandes, siempre que quede suficiente memoria para el sistema operativo y el contexto. Con 32 GB de memoria RAM, se pueden ejecutar cómodamente numerosos modelos de la clase 7B a 14B. También son posibles, en parte, modelos más grandes y fuertemente cuantizados. Con 64 GB, ya hay muchas más posibilidades para modelos con 30 mil millones de parámetros o ventanas de contexto más amplias. Los Macs con 128 GB de memoria unificada ofrecen, además, margen para modelos especialmente grandes, niveles de precisión más altos y el funcionamiento paralelo de varios componentes de IA. Lo decisivo sigue siendo el tamaño real del modelo. El número de parámetros, la cuantización, la longitud del contexto y la arquitectura del modelo deben considerarse siempre en conjunto.
¿Qué ocurre si un modelo de IA necesita más memoria de trabajo de la que ofrece el Mac?
Cuando un modelo de lenguaje necesita demasiada memoria RAM, macOS puede intentar descargar partes de los datos a la SSD. Este llamado swapping evita, en determinadas circunstancias, un cierre inmediato del programa, pero en aplicaciones de IA intensivas en memoria suele provocar pérdidas de rendimiento considerables. La razón es que incluso las SSD rápidas alcanzan una tasa de transferencia de datos claramente inferior a la de la memoria interna. Si durante la generación de texto hay que cambiar constantemente entre SSD y RAM, la velocidad de respuesta puede caer drásticamente. Además, macOS no pone toda la memoria unificada a disposición de las aplicaciones de IA sin restricciones. El sistema operativo, la interfaz gráfica y otros programas también necesitan memoria. Quien quiera evitar estos problemas debería cerrar primero las aplicaciones que no se necesiten, reducir la longitud del contexto o usar una variante del modelo más fuertemente cuantizada. Especialmente con modelos de lenguaje más grandes, una reserva de memoria suficiente es decisiva para un funcionamiento estable y fluido.
11. ¿Qué papel desempeña la cuantización en los sistemas RAG y en el procesamiento de documentos propios?
En Retrieval-Augmented Generation (RAG), los modelos de lenguaje se combinan con una fuente de conocimiento externa. Los documentos se dividen primero en secciones más pequeñas y se convierten en vectores numéricos mediante un modelo de embedding. Una base de datos vectorial permite después buscar secciones de documentos que coincidan en contenido. La cuantización puede aplicarse en distintos puntos. Por ejemplo, el modelo de lenguaje generador puede ejecutarse en Q4 para ahorrar memoria RAM. En cambio, en el modelo de embedding y en el almacenamiento de los vectores hay que tener especial cuidado de preservar la calidad de la búsqueda por similitud. Una compresión demasiado agresiva puede hacer que las secciones relevantes de los documentos se encuentren peor. Incluso un modelo de lenguaje potente podría entonces no recibir la información que necesita para una respuesta correcta. Por eso, en los sistemas RAG deben comprobarse por separado tanto la calidad de la búsqueda de documentos como la calidad de respuesta del modelo de lenguaje.
12. ¿Cómo encuentro la cuantización óptima para mi sistema de IA local?
La mejor cuantización no puede determinarse únicamente a partir del tamaño del modelo o de una tabla de benchmarks. Lo decisivo es qué tareas debe cumplir el modelo de lenguaje en el uso práctico y qué hardware está disponible para ello. Un punto de partida sensato consiste en instalar primero una variante Q4 de alta calidad del modelo deseado. Después deben realizarse tareas típicas, por ejemplo resúmenes de texto, tareas de programación, traducciones o el análisis de documentos propios. Se recomienda observar la calidad de las respuestas, la velocidad, el consumo de memoria y la fiabilidad. Si hay suficiente memoria disponible, el mismo modelo puede probarse adicionalmente en Q8. Los resultados pueden compararse directamente después. Es importante usar condiciones de prueba lo más idénticas posible para ambas variantes. Solo así se harán realmente visibles las diferencias. Al final, no es decisiva la mayor precisión, sino la combinación de calidad suficiente, buena velocidad y ejecución estable en el hardware disponible.