
Kto uruchamia lokalne modele AI za pomocą Ollama, LM Studio lub innych aplikacji na Macach z Apple Silicon, prędzej czy później staje przed kluczowym pytaniem: jak mocno można skompresować model językowy, aby jego jakość odpowiedzi na tym nie ucierpiała? Nowoczesne modele AI wymagają częściowo ogromnych ilości pamięci operacyjnej. Dzięki tak zwanej kwantyzacji można znacznie zmniejszyć to zapotrzebowanie, dzięki czemu nawet wydajne modele mogą być uruchamiane na stosunkowo przystępnym cenowo sprzęcie. Jednak nie każdy poziom kompresji nadaje się w równym stopniu do wymagających zadań.
Między Q2, Q4, Q8 a FP16 istnieją wyraźne różnice pod względem zapotrzebowania na pamięć, szybkości i dokładności. Szczególnie przy złożonych analizach, zadaniach programistycznych czy przetwarzaniu własnych dokumentów różnice te mogą być decydujące. Ten artykuł wyjaśnia techniczne podstawy kwantyzacji, porównuje popularne formaty, takie jak GGUF i MLX, oraz pokazuje, jaki wpływ mają różne poziomy precyzji na lokalne systemy AI. Praktyczne zalecenia pomagają znaleźć sensowny kompromis między wydajnością, zużyciem pamięci a jakością odpowiedzi dla własnego sprzętu i danego zastosowania.


Co oznacza kwantyzacja w modelach lokalnych
Modele językowe różnią się nie tylko swoimi możliwościami, ale także formatem technicznym, w jakim są dostępne. Te formaty określają, jak model jest zapisywany, ładowany i używany – oraz czy w ogóle działa na danym systemie. Do lokalnego użytku w narzędziach takich jak Ollama, LM Studio czy Llama.cpp przyjął się format GGUF. Jest kompaktowy, przenośny i wysoce zoptymalizowany pod kątem inferencji na różnych platformach.
Modele GGUF są zwykle kwantyzowane, co oznacza, że wewnętrzne wartości liczbowe są zapisywane w zredukowanej formie, na przykład w precyzji 4-bitowej lub 8-bitowej. Dzięki temu modele, które pierwotnie miały od 30 do 50 GB, można skompresować do 5–10 GB – przy jedynie niewielkiej utracie jakości. Zaleta: GGUF działa na niemal każdym systemie, od macOS przez Windows po Linux, bez potrzeby posiadania specjalnego GPU. Wada: format nie jest przeznaczony do trenowania ani dostrajania, lecz wyłącznie do czystego użytkowania.
Oprócz GGUF istnieją inne formaty. MLX to własny framework open-source Apple do uczenia maszynowego na Apple Silicon. Został specjalnie zaprojektowany, aby wykorzystać pełną moc CPU, GPU i Neural Engine w układach z serii M. Modele MLX są zwykle dostępne w natywnym formacie MLX lub są konwertowane z innych formatów. Zaleta: maksymalna wydajność i efektywność energetyczna na sprzęcie Apple. Wada: ekosystem jest jeszcze stosunkowo młody, a dostępnych modeli społecznościowych jest mniej niż w przypadku GGUF czy PyTorch.
Safetensors pochodzi ze świata PyTorch i jest silnie promowany przez Hugging Face. To bezpieczny, binarny format przechowywania dużych modeli, który nie pozwala na wykonywanie kodu – stąd nazwa „safe“. Zaleta: bardzo szybkie ładowanie, oszczędność pamięci i standaryzacja. Wada: jest przeznaczony głównie dla frameworków takich jak PyTorch czy TensorFlow, a więc jest raczej powszechny w środowiskach deweloperskich i procesach treningowych. Do bezpośredniego użytku z Ollama lub MLX nie jest kompatybilny.
Kwantyzacja wyjaśniona prosto: dlaczego AI potrzebuje mniej pamięci | widoczność bitowa
Q4, Q8 i FP16: najważniejsze poziomy w porównaniu
Powszechne poziomy kwantyzacji różnią się wyraźnie pod względem dokładności i zapotrzebowania na pamięć. Ollama domyślnie używa kwantyzacji 4-bitowej, co oznacza, że liczba po „q“ wskazuje liczbę bitów używanych do kwantyzacji. Im wyższa liczba, tym dokładniejszy jest model, ale tym wolniej działa i tym więcej pamięci potrzebuje. W przypadku problemów z wyższymi poziomami kwantyzacji zaleca się użycie modelu q4 lub zamknięcie programów zużywających dużo pamięci.
Kwantyzacja 8-bitowa oferuje nieskomplikowany sposób na obniżenie kosztów bez pogarszania jakości. Dzięki zmniejszeniu rozmiaru modelu około czterokrotnie w porównaniu z FP32 wydajność pozostaje niemal taka sama, ze stratą dokładności poniżej 1 procent. Czyni to ją doskonałą opcją na początek dla zespołów, które dopiero zaczynają przygodę z kwantyzacją, i stanowi opcję o niskim lub umiarkowanym ryzyku. Kwantyzacja 4-bitowa jest również praktyczną opcją do zastosowań produkcyjnych, podczas gdy 2-bitowa jest uważana za ryzykowną.
Dla deweloperów i deweloperek uruchamiających lokalne modele na Macach z Apple Silicon wybór poziomu kwantyzacji to wyważenie między zapotrzebowaniem na pamięć a dokładnością. Kwantyzacja 8-bitowa zmniejsza zapotrzebowanie na pamięć o 50 procent, przyspiesza inferencję 1,8-krotnie i zachowuje ponad 99 procent dokładności w wymagających benchmarkach, takich jak HumanEval. Kwantyzacja 4-bitowa jest 11 razy bardziej efektywna niż 2-bitowa pod względem redukcji rozmiaru w stosunku do utraty jakości. W zastosowaniach, w których dokładność ma kluczowe znaczenie, kwantyzacja 8-bitowa (INT8 lub FP8) oferuje niemal bezstratną jakość.
Wpływ na jakość odpowiedzi: gdzie zaczyna się utrata jakości?
Utrata jakości przy niższych poziomach kwantyzacji jest mierzalna i zależy od rozmiaru modelu. W benchmarku ze stycznia 2026 konfiguracja Q4_K_M (4-bitowa) zmniejszyła rozmiar Mistral-7B-Instruct-v0.2 z 7,2 GB do 4,1 GB – redukcja o 43,1 procent – podczas gdy utrata jakości w perplexity wyniosła zaledwie 0,51 procent, co uznaje się za niemal pomijalne. Dalsza redukcja do 2 bitów (Q2_K) doprowadziła jednak do gwałtownego spadku dokładności o 7,94 procent, co określa się mianem „klifu jakości“.
Wariant 70B jest bardziej wrażliwy na kwantyzację. Llama 3.3 70B odnotowała zauważalny spadek o 7,8 punktów w benchmarku MMLU, gdy została zredukowana do 4 bitów. Ten spadek kontrastuje z odpornością mniejszych modeli, takich jak wersja 8B. Oceny wydajności z października 2024 pokazują, że modele skwantyzowane do 8 bitów zachowują 99,9 procent dokładności swoich odpowiedników w pełnej precyzji, podczas gdy modele 4-bitowe utrzymują około 98,9 procent w benchmarkach takich jak HumanEval+.
Red Hat Developer przeprowadził ponad pół miliona ocen i stwierdził, że dobrze skwantyzowane modele odzyskują średnio 99 procent wyniku bazowego, przy czym wszystkie modele wykazują co najmniej 96 procent odzyskania. Jakość odpowiedzi modeli skwantyzowanych pozostaje wysoce konkurencyjna w stosunku do ich nieskwantyzowanych odpowiedników. Przedziały ufności 95 procent nakładają się dla wszystkich rozmiarów modeli i schematów kwantyzacji, co podkreśla minimalny wpływ na dokładność.
Zużycie RAM i szybkość na Apple Silicon
Gdy model językowy działa lokalnie, pamięć operacyjna (RAM, a w przypadku Apple: „Unified Memory“) ma kluczowe znaczenie. Sam model, w tym wagi, aktywacje i wyniki pośrednie, musi być przechowywany w pamięci. Im większy model, tym więcej pamięci jest potrzebne. Układy Apple Silicon wykorzystują „Unified Memory“, co oznacza, że CPU, GPU i Neural Engine korzystają z tej samej puli pamięci. Dzięki temu eliminowane są kopie danych między komponentami, co zwiększa wydajność i szybkość.
Jeśli nie ma wystarczającej ilości RAM, system musi korzystać z pliku wymiany lub modele nie są w pełni ładowane – co może prowadzić do spadków wydajności, niestabilności lub przerwania działania. Szczególnie w zastosowaniach inferencyjnych, takich jak generowanie odpowiedzi, wprowadzanie tekstu czy rozszerzanie modelu, liczy się czas reakcji i przepustowość, a tutaj odpowiednia ilość pamięci znacząco pomaga. Tradycyjny komputer stacjonarny myślał kiedyś w kategoriach „RAM CPU“ i „osobny RAM GPU“ – w Apple Silicon jest to elegancko połączone, co czyni uruchamianie modeli językowych szczególnie atrakcyjnym.
Dla mniejszych modeli, na przykład z kilkoma miliardami parametrów, 16 do 32 GB RAM może wystarczyć, zwłaszcza jeśli mają być przetwarzane tylko pojedyncze zapytania. Mac Mini z 16/32 GB byłby więc punktem wyjścia. Dla średnich modeli, na przykład z 3 do 10 miliardów parametrów, lub zadań z wieloma równoległymi czatami bądź większymi ilościami tekstu, należy rozważyć 32 GB RAM lub więcej, np. Mac Studio z 32 lub 48 GB. Dla dużych modeli, powyżej 20 miliardów parametrów, lub gdy kilka modeli ma działać równolegle, można wybrać 64 GB lub więcej.
Ważne jest zaplanowanie pewnego bufora, ponieważ nie tylko model, ale także system operacyjny, operacje wejścia-wyjścia plików czy inne aplikacje potrzebują rezerw pamięci. Dla małych modeli (1–3 mld parametrów) zaleca się 16–32 GB RAM, dla średnich modeli (7–13 mld parametrów) 32–64 GB, a dla dużych modeli (30–70 mld parametrów) 64 GB lub więcej. Umożliwia to efektywne uruchamianie modeli takich jak qwen3-coder:30b z 19 GB przy Q4_K_M lub gpt-oss:20b z 16 GB RAM.
Praktyczna rekomendacja: który poziom dla jakiego przypadku użycia?
Wybór odpowiedniego poziomu kwantyzacji zależy bezpośrednio od konkretnego celu zastosowania i wymogów ochrony danych. Lokalne modele językowe sprawdzają się szczególnie tam, gdzie poufność jest konieczna lub wymagane są procesy w czasie rzeczywistym. W praktyce okazuje się, że branże takie jak kancelarie prawne czy medycyna stawiają na rozwiązania lokalne, aby przetwarzać wrażliwe dane pacjentów lub pisma procesowe bez zależności od chmury. Również w produkcji książek i mediów czy w obszarze systemów ERP lokalne modele umożliwiają automatyczne analizy tekstu i sugestie generowane bezpośrednio z oprogramowania. Dla biur inżynierskich i architektów asystenci ci są dodatkową zaletą, ponieważ działają niezawodnie także bez połączenia z internetem. Przedsiębiorstwa ogólnie korzystają z wewnętrznych asystentów czatu i analiz protokołów, które pozostają w całości we własnej sieci.
Istotną praktyczną zaletą modeli lokalnych w porównaniu z usługami chmurowymi jest szybkość reakcji. Podczas gdy zewnętrzne API mogą być opóźniane przez trasy sieciowe lub obciążenie serwera, modele lokalne odpowiadają w zależności od sprzętu niemal w czasie rzeczywistym. Ma to decydujące znaczenie dla przepływu pracy, zwłaszcza przy powtarzalnych zadaniach lub procesach interaktywnych, takich jak analiza danych na żywo. W sektorze komercyjnym działanie na własnych maszynach umożliwia ponadto dostosowywanie i dostrajanie modeli przy użyciu wiedzy firmowej. W ten sposób powstaje infrastruktura IT, która wykorzystuje nowoczesną technologię, nie rezygnując z kontroli nad własnymi danymi. Decyzji o konkretnym poziomie kwantyzacji nie należy zatem rozpatrywać w oderwaniu, lecz jako część strategii łączącej suwerenność i wydajność.
Kwantyzacja w systemach RAG: na co zwrócić uwagę
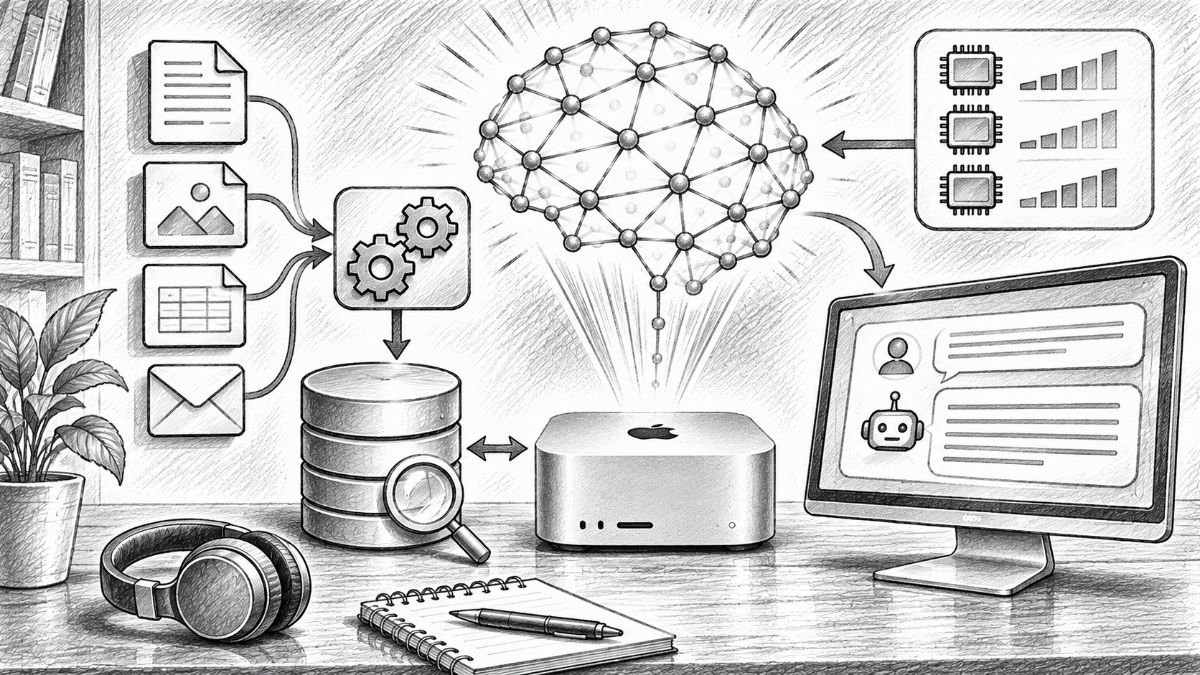
W systemach Retrieval-Augmented Generation (RAG) kwantyzacja odgrywa kluczową rolę, ponieważ model językowy jest tu łączony z wyszukiwaniem w zbiorach dokumentów lub bazach danych. Procedura ta służy zwiększeniu wiarygodności generowanych odpowiedzi i uzupełnianiu luk w wiedzy modelu za pomocą wiedzy zewnętrznej. RAG jest szczególnie przydatny w scenariuszach wymagających intensywnej wiedzy, ponieważ może łagodzić halucynacje, umożliwiając modelowi korzystanie z istotnych, aktualnie pobranych informacji. Dzięki temu można wykorzystać potencjał dużych modeli językowych dla danych wewnętrznych bez konieczności kosztownego dostrajania.
Realizacja techniczna wymaga, aby dokumenty zostały najpierw podzielone na mniejsze fragmenty i przekształcone w formę wektorową (embeddingi) za pomocą Ollama. Wektory te są następnie umieszczane w odpowiedniej bazie danych, takiej jak Qdrant. Przy wyborze poziomu kwantyzacji dla procesu osadzania należy pamiętać, że zbyt agresywna kompresja może pogorszyć obliczanie podobieństwa. W praktyce należy zatem rozważyć, czy oszczędność pamięci wynikająca z niższych poziomów uzasadnia potencjalne zmniejszenie dokładności wyszukiwania. Często okazuje się, że dla modeli osadzających wyższa precyzja niż dla samego generującego modelu językowego jest korzystna, aby zapewnić pobranie właściwych fragmentów kontekstu.
Wybór poziomu kwantyzacji jest ostatecznie kompromisem między zużyciem zasobów a dokładnością. W systemach RAG chodzi o zharmonizowanie precyzji wyszukiwania i wydajności generatora, aby osiągnąć wiarygodne wyniki.
Źródła dotyczące kwantyzacji LLM
- Apple MLX vs. NVIDIA: Jak działa lokalna sztuczna inteligencja na komputerach Mac?
- Lokalny AI na Macu: jak zainstalować model językowy za pomocą Ollama
- RAG z Ollama i Qdrant jako uniwersalna wyszukiwarka własnych danych
- llama2
- Testowaliśmy skwantyzowane LLM-y: Wyniki kosztów i wydajności | Latitude
- Przeprowadziliśmy ponad pół miliona ewaluacji na skwantyzowanych LLM-ach — oto, co odkryliśmy | Red Hat Developer
- Najlepsze modele Ollama 2026: 25+ Ranking według VRAM i SWE-Bench (październik 2026) | Morph
- Retrieval Augmented Generation (RAG): czat z własnymi danymi
- Retrieval Augmented Generation (RAG) dla LLM | Prompt Engineering Guide

Często zadawane pytania dotyczące kwantyzacji lokalnych modeli AI
Co oznacza kwantyzacja w modelu językowym AI?
Kwantyzacja to proces, w którym zmniejsza się precyzję numeryczną wag modelu językowego AI. Podczas gdy modele niekwantyzowane często pracują na liczbach zmiennoprzecinkowych 16-bitowych lub 32-bitowych, warianty skwantyzowane używają na przykład tylko 8, 4, a nawet 2 bitów na wagę. Dzięki temu znacznie zmniejsza się wymagana przestrzeń pamięci, bez konieczności ponownego trenowania modelu. Kluczową zaletą jest to, że większe modele językowe można uruchamiać na komputerach z ograniczoną pamięcią RAM. Na przykład model, który pierwotnie potrzebuje około 60 GB pamięci na swoje wagi, można dzięki kwantyzacji 4-bitowej zredukować do około 15 do 20 GB. Rzeczywisty rozmiar zależy od zastosowanej metody kwantyzacji. Jednak podczas konwersji tracone są informacje, dlatego jakość odpowiedzi może być w różnym stopniu pogorszona w zależności od modelu i przypadku użycia.
Jaka jest różnica między Q2, Q4, Q8 a FP16?
Oznaczenia Q2, Q4, Q8 i FP16 opisują różne poziomy precyzji przy przechowywaniu wag modelu. FP16 używa 16-bitowych liczb zmiennoprzecinkowych i oferuje wysoką precyzję numeryczną, ale wymaga stosunkowo dużo pamięci RAM. Q8 redukuje wagi do około 8 bitów i często osiąga niemal niezmienioną jakość odpowiedzi przy znacznie mniejszym zapotrzebowaniu na pamięć. Q4 używa przeważnie 4 bitów na wagę i dlatego stanowi szczególnie atrakcyjny kompromis dla wielu zastosowań lokalnych. Zużycie pamięci znacznie spada, a jakość w wielu modelach pozostaje na wysokim poziomie. Q2 kompresuje jeszcze mocniej, ale może powodować znacznie większe straty jakości. Ważne jest, że te oznaczenia opisują tylko podstawową precyzję. Warianty kwantyzacji, takie jak Q4_K_M, stosują dodatkowe metody, aby jak najlepiej zachować dokładność szczególnie ważnych wag modelu.
Ile pamięci RAM można faktycznie zaoszczędzić dzięki kwantyzacji?
Możliwa oszczędność pamięci zależy od pierwotnej precyzji, rozmiaru modelu i wybranej metody kwantyzacji. W porównaniu z FP16 czysta reprezentacja 8-bitowa wymaga około połowy pamięci na wagi modelu. Przy 4 bitach teoretyczne zapotrzebowanie spada do około jednej czwartej. W praktyce modele są nieco większe, ponieważ trzeba przechowywać dodatkowe informacje o kwantyzacji. Model językowy z 30 miliardami parametrów potrzebuje w FP16 tylko na swoje wagi około 60 GB. Wariant 8-bitowy potrzebuje około 30 GB, podczas gdy wersja 4-bitowa często mieści się w zakresie około 18 do 20 GB. Wartości te nie opisują jednak całkowitego zapotrzebowania na pamięć RAM podczas użytkowania. Dodatkowo należy uwzględnić między innymi pamięć kontekstu, obliczenia tymczasowe i system operacyjny. Dlatego przy wyborze modelu zawsze należy zaplanować odpowiednią rezerwę pamięci.
Jak bardzo kwantyzacja Q4 pogarsza jakość odpowiedzi modelu językowego?
W wielu nowoczesnych modelach językowych wysokiej jakości kwantyzacja 4-bitowa powoduje tylko stosunkowo niewielkie straty jakości. Szczególnie w codziennych zadaniach, takich jak streszczenia tekstów, tłumaczenia, proste zadania programistyczne czy ogólne pytania wiedzowe, różnice w porównaniu z wariantami o wyższej precyzji są często trudne do zauważenia. Jednak rzeczywista jakość silnie zależy od konkretnego modelu i zadania. Przy złożonych obliczeniach matematycznych, wymagających zadaniach programistycznych lub wieloetapowych wnioskowaniach logicznych małe odchylenia numeryczne mogą mieć większe skutki. Istotną rolę odgrywa również wybrana metoda kwantyzacji. Metody takie jak Q4_K_M starają się zachować szczególnie wrażliwe obszary modelu z wyższą dokładnością. Dla wielu użytkowników Q4 jest zatem rozsądnym punktem wyjścia. Kto potrzebuje szczególnie wiarygodnych wyników, powinien dodatkowo przetestować ten sam model w Q8 i porównać odpowiedzi na typowych zadaniach.
Kiedy warto wybrać Q8 lub FP16 zamiast mniejszej wersji Q4?
Wyższa precyzja może być szczególnie sensowna, gdy model językowy ma wykonywać wymagające zadania i dostępna jest wystarczająca ilość pamięci RAM. Należą do nich na przykład złożone tworzenie oprogramowania, analizy naukowe, obliczenia matematyczne lub obszerne analizy z wieloma następującymi po sobie krokami myślowymi. Q8 często stanowi dobry kompromis. Wagi modelu potrzebują około dwa razy więcej pamięci niż przy porównywalnej kwantyzacji 4-bitowej, ale jakość jest zwykle bardzo zbliżona do wersji wyjściowej o wyższej precyzji. FP16 wchodzi w grę przede wszystkim wtedy, gdy potrzebna jest maksymalna precyzja numeryczna, a sprzęt jest w stanie obsłużyć znaczne zapotrzebowanie na pamięć. Gwarancji bezbłędnych odpowiedzi nie daje jednak również FP16. W wielu praktycznych zastosowaniach wydajniejszy model w Q4 może być lepszym wyborem niż znacznie mniejszy model w FP16.
Dlaczego modele AI skwantyzowane do 2 bitów mogą być problematyczne?
Przy kwantyzacji 2-bitowej dostępnych jest znacznie mniej stopni do reprezentacji wag modelu niż przy 4 lub 8 bitach. Dzięki temu modele językowe można wprawdzie szczególnie mocno skompresować, ale ważne informacje o zależnościach wewnątrz sieci neuronowej mogą zostać utracone. Straty te niekoniecznie ujawniają się przy prostych pytaniach. Trudności pojawiają się często dopiero przy bardziej złożonych zadaniach, które wymagają precyzyjnych obliczeń, dłuższych ciągów myślowych lub niezawodnego przetwarzania obszernych informacji. Odpowiedzi mogą wtedy stać się mniej dokładne, bardziej sprzeczne lub mniej stabilne. Szczególnie problematyczne jest to, że takie straty jakości nie zawsze są oczywiste. Model może nadal formułować przekonująco, mimo że jego wyniki zawierają błędy merytoryczne. Q2 nadaje się zatem przede wszystkim do zastosowań eksperymentalnych lub sytuacji z bardzo ograniczoną pamięcią. Dla wymagających systemów produkcyjnych Q4 i Q8 są zwykle bardziej niezawodną bazą wyjściową.
Jakie różnice występują między GGUF, MLX a Safetensors?
GGUF, MLX i Safetensors są często wymieniane w kontekście lokalnych modeli AI, ale pełnią różne funkcje. GGUF to format modelu, który jest szczególnie rozpowszechniony w środowisku llama.cpp, Ollama i LM Studio. Obsługuje różne metody kwantyzacji i umożliwia uruchamianie modeli językowych na różnych platformach sprzętowych. MLX to natomiast opracowany przez Apple framework uczenia maszynowego, który jest specjalnie dostosowany do architektury Apple Silicon. Dzięki MLX modele językowe mogą być wydajnie uruchamiane na komputerach Mac z procesorami z serii M. Dostępne są również specjalnie skwantyzowane warianty modeli. Safetensors to bezpieczny format plików do przechowywania numerycznych wag modeli. Jest często używany w środowisku Hugging Face i PyTorch. Wybór formatu zależy zatem od używanego środowiska uruchomieniowego. Na komputerach Mac z Apple Silicon sensowne mogą być zarówno modele GGUF, jak i MLX, przy czym ich szybkość różni się w zależności od modelu i implementacji.
Czy skwantyzowane modele AI automatycznie stają się szybsze?
Niekoniecznie. Kwantyzacja przede wszystkim zmniejsza zapotrzebowanie modelu na pamięć. Dzięki temu podczas przetwarzania często trzeba odczytywać mniej danych z pamięci RAM, co może przynieść znaczne korzyści szczególnie w obliczeniach zależnych od przepustowości pamięci. Na komputerach Mac z Apple Silicon efekt ten jest szczególnie interesujący, ponieważ CPU i GPU korzystają ze wspólnej puli pamięci. Mniejsze wagi modelu mogą być efektywniej przesyłane i przetwarzane. Dlatego skwantyzowane modele w wielu przypadkach osiągają wyższą szybkość generowania tekstu. Jednak przetwarzanie skwantyzowanych wag wymaga częściowo dodatkowych operacji obliczeniowych w celu odtworzenia odpowiednich wartości liczbowych. To, który wariant jest faktycznie szybszy, zależy zatem od sprzętu, używanego oprogramowania i konkretnej metody kwantyzacji. Oprócz czystej szybkości w tokenach na sekundę należy również uwzględnić czas do pierwszej odpowiedzi. Szczególnie w zastosowaniach interaktywnych szybki czas reakcji może być ważniejszy niż maksymalna wydajność generowania.
Jaki poziom kwantyzacji nadaje się do komputerów Mac z 16, 32, 64 lub 128 GB pamięci RAM?
Odpowiednia kwantyzacja zależy zarówno od dostępnej pojemności pamięci, jak i od rozmiaru pożądanego modelu językowego. Na komputerach Mac z 16 GB pamięci zunifikowanej sprawdzają się przede wszystkim mniejsze modele o kilku miliardach parametrów. Dzięki kwantyzacji Q4 również pojedyncze większe modele mogą stać się użyteczne, o ile pozostanie wystarczająco dużo pamięci dla systemu operacyjnego i kontekstu. Z 32 GB pamięci RAM można wygodnie uruchamiać liczne modele z klasy od 7B do 14B. Częściowo możliwe są także większe, mocno skwantyzowane modele. Przy 64 GB dostępnych jest już znacznie więcej możliwości dla modeli o 30 miliardach parametrów lub obszerniejszych okien kontekstowych. Komputery Mac z 128 GB pamięci zunifikowanej oferują ponadto zapas na szczególnie duże modele, wyższe poziomy precyzji i równoległe działanie kilku komponentów AI. Decydujący pozostaje rzeczywisty rozmiar modelu. Liczba parametrów, kwantyzacja, długość kontekstu i architektura modelu muszą być zawsze rozpatrywane łącznie.
Co się dzieje, gdy model AI potrzebuje więcej pamięci RAM, niż może zapewnić Mac?
Gdy model językowy potrzebuje zbyt dużo pamięci RAM, macOS może próbować przenieść część danych na dysk SSD. To tak zwane swapowanie w określonych okolicznościach zapobiega natychmiastowemu zamknięciu programu, jednak w przypadku aplikacji AI intensywnie korzystających z pamięci często prowadzi do znacznego spadku wydajności. Powodem jest to, że nawet szybkie dyski SSD osiągają wyraźnie niższą szybkość transferu danych niż wewnętrzna pamięć RAM. Jeśli podczas generowania tekstu trzeba stale przełączać się między SSD a RAM, szybkość odpowiedzi może drastycznie spaść. Dochodzi do tego fakt, że macOS nie udostępnia całej pamięci zunifikowanej bez ograniczeń dla aplikacji AI. System operacyjny, interfejs graficzny i inne programy również potrzebują pamięci. Kto chce uniknąć takich problemów, powinien najpierw zamknąć niepotrzebne aplikacje, zmniejszyć długość kontekstu lub użyć mocniej skwantyzowanej wersji modelu. Zwłaszcza w przypadku większych modeli językowych wystarczająca rezerwa pamięci ma kluczowe znaczenie dla stabilnego i płynnego działania.
11. Jaką rolę odgrywa kwantyzacja w systemach RAG i przetwarzaniu własnych dokumentów?
W generowaniu wspomaganym wyszukiwaniem (RAG) modele językowe są łączone z zewnętrznym źródłem wiedzy. Dokumenty są najpierw dzielone na mniejsze fragmenty i przekształcane w wektory numeryczne za pomocą modelu osadzania. Wektorowa baza danych umożliwia następnie wyszukiwanie fragmentów dokumentów pasujących pod względem treści. Kwantyzacja może być przy tym stosowana w różnych miejscach. Generujący model językowy można na przykład uruchamiać w Q4, aby zaoszczędzić pamięć RAM. W przypadku modelu osadzania i przechowywania wektorów należy natomiast szczególnie dbać o zachowanie jakości wyszukiwania podobieństw. Zbyt agresywna kompresja może sprawić, że istotne fragmenty dokumentów będą gorzej znajdowane. Nawet wydajny model językowy może wtedy nie otrzymać informacji potrzebnych do udzielenia poprawnej odpowiedzi. Dlatego w systemach RAG należy oddzielnie sprawdzać zarówno jakość wyszukiwania dokumentów, jak i jakość odpowiedzi modelu językowego.
12. Jak znaleźć optymalną kwantyzację dla mojego lokalnego systemu AI?
Najlepszej kwantyzacji nie da się określić wyłącznie na podstawie rozmiaru modelu lub tabeli benchmarków. Decydujące jest to, jakie zadania model językowy ma spełniać w praktyce i jaki sprzęt jest do tego dostępny. Rozsądnym punktem wyjścia jest najpierw zainstalowanie wysokiej jakości wariantu Q4 pożądanego modelu. Następnie należy wykonać typowe zadania, na przykład streszczenia tekstów, zadania programistyczne, tłumaczenia lub analizę własnych dokumentów. Przy tym warto obserwować jakość odpowiedzi, szybkość, zużycie pamięci i niezawodność. Jeśli dostępna jest wystarczająca ilość pamięci, ten sam model można dodatkowo przetestować w Q8. Wyniki można następnie bezpośrednio porównać. Ważne jest, aby dla obu wariantów stosować możliwie identyczne warunki testowe. Tylko wtedy różnice staną się faktycznie widoczne. Ostatecznie nie najwyższa precyzja jest decydująca, lecz połączenie wystarczającej jakości, dobrej szybkości i stabilnego działania na dostępnym sprzęcie.