
Wiegen wie u de lokale AI-modellen met Ollama, LM Studio of andere toepassingen op Apple Silicon Macs, staat u vroeg of laat voor een cruciale vraag: hoe sterk kan een taalmodel worden gecomprimeerd zonder dat de kwaliteit van de antwoorden eronder lijdt? Moderne AI-modellen hebben soms enorme hoeveelheden werkgeheugen nodig. Door middel van zogenaamde kwantisatie kan deze behoefte aanzienlijk worden verminderd, zodat zelfs krachtige modellen kunnen worden uitgevoerd op relatief betaalbare hardware. Maar niet elk compressieniveau is even geschikt voor veeleisende taken.
Tussen Q2, Q4, Q8 en FP16 bestaan duidelijke verschillen qua geheugenbehoefte, snelheid en nauwkeurigheid. Vooral bij complexe analyses, programmeertaken of het verwerken van eigen documenten kunnen deze verschillen beslissend zijn. Dit artikel legt de technische grondslagen van kwantisering uit, vergelijkt gangbare formaten zoals GGUF en MLX en laat zien welke gevolgen de verschillende precisieniveaus hebben voor lokale AI-systemen. Praktijkgerichte aanbevelingen helpen om voor de eigen hardware en het betreffende gebruik een zinvol compromis te vinden tussen prestaties, geheugengebruik en antwoordkwaliteit.
Wat kwantisering bij lokale modellen betekent
Taalmodellen onderscheiden zich niet alleen door hun capaciteiten, maar ook door het technische formaat waarin ze beschikbaar zijn. Deze formaten bepalen hoe een model wordt opgeslagen, geladen en gebruikt – en of het op een bepaald systeem überhaupt kan draaien. Voor lokaal gebruik in tools zoals Ollama, LM Studio of Llama.cpp heeft het GGUF-formaat zich gevestigd. Het is compact, overdraagbaar en sterk geoptimaliseerd voor inferentie op verschillende platforms.
GGUF-modellen worden meestal gekwantiseerd, wat betekent dat de interne getalwaarden met minder precisie worden opgeslagen, bijvoorbeeld in 4-bits- of 8-bits-precisie. Daardoor kunnen modellen die oorspronkelijk 30 tot 50 GB groot waren, worden gecomprimeerd tot 5 tot 10 GB – met slechts een klein kwaliteitsverlies. Het voordeel: GGUF draait op vrijwel elk systeem, van macOS tot Windows en Linux, zonder dat een speciale GPU nodig is. Het nadeel: het formaat is niet bedoeld voor training of fine-tuning, maar uitsluitend voor het gewone gebruik.
Naast GGUF bestaan er andere formaten. MLX is Apples eigen opensource-framework voor machine learning op Apple Silicon. Het is speciaal ontwikkeld om de volledige prestaties van CPU, GPU en Neural Engine in M-chips te benutten. MLX-modellen zijn meestal beschikbaar in het native MLX-formaat of worden uit andere formaten geconverteerd. Het voordeel: maximale prestaties en energie-efficiëntie op Apple-hardware. Het nadeel: het ecosysteem is nog relatief jong en er zijn minder communitymodellen beschikbaar dan bij GGUF of PyTorch.
Safetensors komt uit de PyTorch-wereld en wordt sterk gestimuleerd door Hugging Face. Het is een veilig binair opslagformaat voor grote modellen dat geen code-uitvoering toestaat – vandaar de naam „safe“. Het voordeel: zeer snel te laden, geheugenbesparend en gestandaardiseerd. Het nadeel: het is hoofdzakelijk bedoeld voor frameworks zoals PyTorch of TensorFlow, dus eerder gebruikelijk in ontwikkelomgevingen en voor trainingsprocessen. Voor direct gebruik met Ollama of MLX is het niet compatibel.
Kwantisering eenvoudig uitgelegd: waarom AI minder geheugen nodig heeft | uitsicht
Q4, Q8 en FP16: de belangrijkste niveaus vergeleken
De gangbare kwantiseringsniveaus verschillen duidelijk in nauwkeurigheid en geheugenbehoefte. Ollama gebruikt standaard 4-bits-kwantisering, wat betekent dat het getal na de „q“ het aantal bits aangeeft dat voor de kwantisering wordt gebruikt. Hoe hoger het getal, hoe nauwkeuriger het model, maar hoe langzamer het draait en hoe meer geheugen het nodig heeft. Bij problemen met hogere kwantiseringsniveaus is het raadzaam het q4-model te gebruiken of programma's die veel geheugen gebruiken te sluiten.
8-bits-kwantisering biedt een eenvoudige manier om kosten te verlagen zonder de kwaliteit aan te tasten. Door de modelgrootte met ongeveer een factor vier te verkleinen ten opzichte van FP32 blijft de prestatie vrijwel gelijk, met een nauwkeurigheidsverlies van minder dan 1 procent. Dit maakt het een uitstekende instapoptie voor teams die nieuw zijn in kwantisering, en biedt het een optie met laag tot matig risico. 4-bits-kwantisering is eveneens een praktische optie voor productiegebruik, terwijl 2-bits als riskant geldt.
Voor ontwikkelaars die lokale modellen draaien op Apple Silicon Macs, is de keuze van het kwantisatieniveau een afweging tussen geheugengebruik en nauwkeurigheid. 8-bit kwantisatie vermindert het geheugengebruik met 50 procent, versnelt de inferentie met de 1,8-voud en behoudt meer dan 99 procent nauwkeurigheid op veeleisende benchmarks zoals HumanEval. 4-bit kwantisatie is 11 keer efficiënter dan 2-bit wat betreft de omvangreductie in verhouding tot het kwaliteitsverlies. Voor toepassingen waarbij nauwkeurigheid cruciaal is, biedt 8-bit kwantisatie (INT8 of FP8) een bijna verliesvrije kwaliteit.
De invloed op de antwoordkwaliteit: waar begint het kwaliteitsverlies?
Het kwaliteitsverlies bij lagere kwantiseringsniveaus is meetbaar en hangt af van de modelgrootte. In een benchmark in januari 2026 verkleinde de Q4_K_M (4-bits)-configuratie de grootte van Mistral-7B-Instruct-v0.2 van 7,2 GB naar 4,1 GB – een reductie van 43,1 procent – terwijl het kwaliteitsverlies in de perplexiteit slechts 0,51 procent bedroeg, wat als vrijwel verwaarloosbaar geldt. Een verdere reductie naar 2-bits (Q2_K) leidde echter tot een steil nauwkeurigheidsverlies van 7,94 procent, wat wordt aangeduid als de „kwaliteitsklif“.
De 70B-variant is gevoeliger voor kwantisering. Llama 3.3 70B leed een merkbare teruggang van 7,8 punten op de MMLU-benchmark toen het tot 4-bits werd gereduceerd. Deze achteruitgang staat in contrast met de robuustheid van kleinere modellen zoals de 8B-versie. Prestatiebeoordelingen uit oktober 2024 tonen aan dat 8-bits-gekwantiseerde modellen 99,9 procent van de nauwkeurigheid van hun volledige-precisie-equivalenten behouden, terwijl 4-bits-modellen ongeveer 98,9 procent behouden op benchmarks zoals HumanEval+.
Red Hat Developer voerde meer dan een half miljoen evaluaties uit en stelde vast dat goed gequantiseerde modellen gemiddeld 99 procent van de baseline-score herstellen, waarbij alle modellen ten minste 96 procent herstel vertonen. De antwoordkwaliteit van gequantiseerde modellen blijft zeer concurrerend met hun niet-gequantiseerde tegenhangers. De 95-procentsbetrouwbaarheidsintervallen overlappen elkaar voor alle modelgroottes en quantisatieschema's, wat de minimale invloed op de nauwkeurigheid onderstreept.
RAM-gebruik en snelheid op Apple Silicon
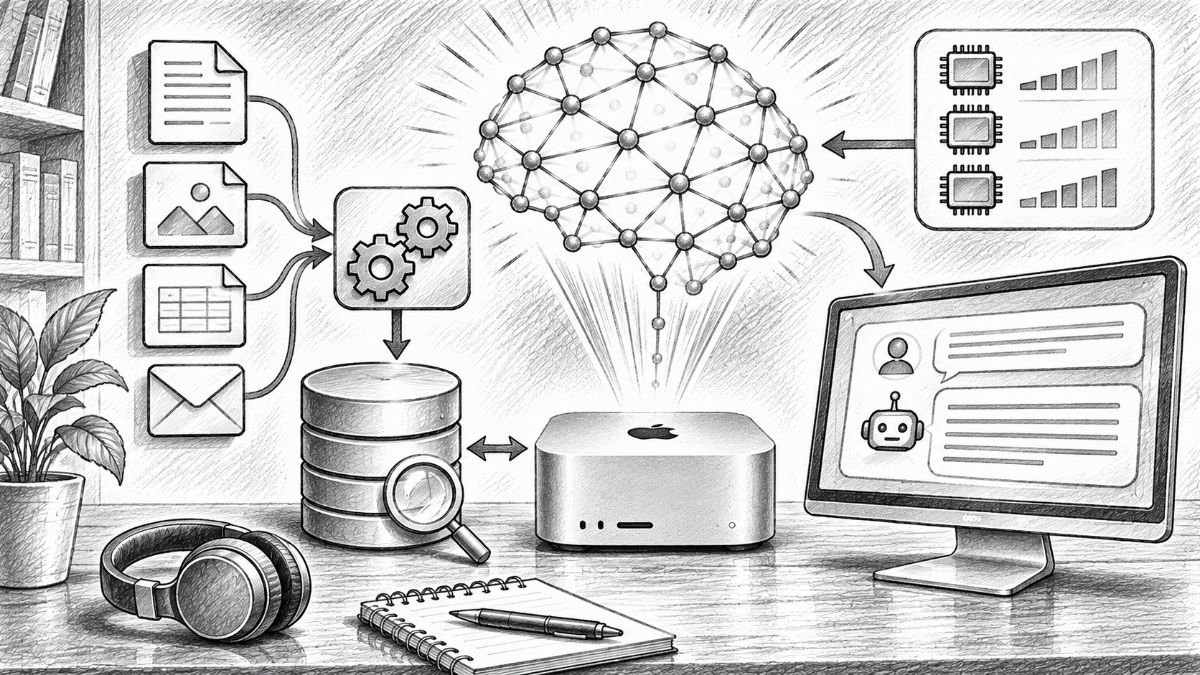
Wanneer een taalmodel lokaal draait, is het werkgeheugen (RAM of bij Apple: „Unified Memory“) van cruciaal belang. Het model zelf, inclusief gewichten, activaties en tussenresultaten, moet in het geheugen worden gehouden. Hoe groter het model, hoe meer geheugen er nodig is. Apple Silicon-chips gebruiken „Unified Memory“, wat betekent dat CPU, GPU en Neural Engine toegang hebben tot dezelfde geheugenpool. Daardoor vervallen gegevenskopieën tussen componenten, wat de efficiëntie en snelheid verhoogt.
Als er niet genoeg RAM beschikbaar is, moet het systeem uitbesteden of worden modellen niet volledig geladen – wat kan leiden tot prestatieverlies, instabiliteit of afbreken. Juist bij inferentiële toepassingen, zoals antwoordgeneratie, tekstinvoer of modelextensie, draait het om reactietijd en doorvoer, en hier helpt voldoende geheugen aanzienlijk. Een traditionele desktop-pc dacht vroeger in „CPU-RAM“ en „afzonderlijk GPU-RAM“ – bij Apple Silicon is het elegant verenigd, wat het uitvoeren van taalmodellen bijzonder aantrekkelijk maakt.
Voor kleinere modellen, bijvoorbeeld met enkele miljarden parameters, zouden 16 tot 32 GB RAM voldoende kunnen zijn, vooral als alleen afzonderlijke verzoeken worden verwerkt. Een Mac Mini met 16/32 GB zou dus een instap zijn. Voor middelgrote modellen, bijvoorbeeld met 3 tot 10 miljard parameters, of taken met meerdere parallelle chats of grotere tekstvolumes zou men 32 GB RAM of meer in overweging moeten nemen, bijvoorbeeld een Mac Studio met 32 of 48 GB. Voor grote modellen, boven 20 miljard parameters, of wanneer meerdere modellen parallel moeten draaien, zou men 64 GB of meer kunnen kiezen.
Het is belangrijk om wat buffer in te plannen, omdat niet alleen het model, maar ook de bedrijfsvoering, zoals het besturingssysteem, bestands-I/O of andere applicaties, geheugenreserves nodig heeft. Voor kleine modellen (1-3 mld parameters) wordt 16-32 GB RAM aanbevolen, voor middelgrote modellen (7-13 mld parameters) 32-64 GB, en voor grote modellen (30-70 mld parameters) 64 GB of meer. Dit maakt het mogelijk om modellen zoals qwen3-coder:30b met 19 GB bij Q4_K_M of gpt-oss:20b met 16 GB RAM efficiënt te draaien.
Praktijkadvies: welke stap voor welk gebruiksscenario?
De keuze van de juiste quantisatiestap hangt rechtstreeks af van het concrete gebruiksdoel en de vereisten op het gebied van gegevensbescherming. Lokale taalmodellen zijn bijzonder geschikt waar vertrouwelijkheid verplicht is of realtimeprocessen vereist zijn. In de praktijk blijkt dat branches zoals de advocatuur of de medische sector lokale oplossingen inzetten om gevoelige patiëntgegevens of processtukken zonder cloudafhankelijkheid te verwerken. Ook in de boek- en mediaproductie of op het gebied van ERP-systemen maken lokale modellen automatische tekstanalyses en suggesties mogelijk die rechtstreeks vanuit de software worden gegenereerd. Voor ingenieursbureaus en architecten zijn deze assistenten bovendien een voordeel, omdat ze ook zonder internetverbinding betrouwbaar functioneren. Bedrijven profiteren in het algemeen van interne chatassistenten en protocolanalyses die volledig binnen het eigen netwerk blijven.
Een wezenlijk praktisch voordeel van lokale modellen ten opzichte van clouddiensten is de reactiesnelheid. Terwijl externe API's door netwerkroutes of serverbelasting kunnen worden vertraagd, reageren lokale modellen afhankelijk van de hardware vrijwel in realtime. Dit is vooral bij herhaalde taken of interactieve processen, zoals een live data-analyse, beslissend voor de werkstroom. In de zakelijke sector maakt het draaien op eigen machines bovendien de aanpassing en fijnafstelling van de modellen met bedrijfseigen kennis mogelijk. Zo ontstaat een IT-landschap dat moderne technologie gebruikt zonder de soevereiniteit over de eigen gegevens op te geven. De keuze voor een bepaalde quantisatiestap moet daarom niet geïsoleerd worden bekeken, maar worden begrepen als onderdeel van een strategie die soevereiniteit en prestatievermogen verenigt.
Quantisatie in RAG-systemen: let op bijzonderheden
In Retrieval-Augmented-Generation-systemen (RAG) speelt quantisatie een centrale rol, omdat hier het taalmodel wordt gecombineerd met een zoekfunctie in documentverzamelingen of databases. Deze methode dient om de betrouwbaarheid van de gegenereerde antwoorden te vergroten en kennislacunes van het model met externe kennis te dichten. RAG is bijzonder nuttig in kennisintensieve scenario's, omdat het hallucinaties kan verzachten doordat het model teruggrijpt op relevante, actueel opgehaalde informatie. Daardoor kunnen de mogelijkheden van grote taalmodellen voor interne gegevens worden benut zonder omslachtige fijnafstellingen te hoeven uitvoeren.
De technische implementatie vereist dat documenten eerst in kleinere secties worden opgedeeld en in vectorvorm (embeddings) via Ollama worden gegenereerd. Deze vectoren worden vervolgens in een passende database, zoals Qdrant, ingevoegd. Bij de keuze van de quantisatiestap voor het embeddingproces moet erop worden gelet dat een te agressieve compressie de gelijkenisberekening kan beïnvloeden. In de praktijk moet daarom worden afgewogen of de geheugenbesparing door lagere stappen de mogelijke vermindering van de zoeknauwkeurigheid rechtvaardigt. Vaak blijkt dat voor de embeddingmodellen een hogere precisie dan voor het genererende taalmodel zelf voordelig is, om ervoor te zorgen dat de juiste contextstukken worden opgehaald.
De keuze van de quantisatiestap is uiteindelijk een compromis tussen resourceverbruik en nauwkeurigheid. Voor RAG-systemen geldt dat de precisie van de zoekfunctie en de prestaties van de generator met elkaar in overeenstemming moeten worden gebracht om betrouwbare resultaten te behalen.
Bronnen over quantisatie van LLM's
- Apple MLX vs. NVIDIA: Hoe lokale AI-inferentie werkt op de Mac
- Lokale AI op de Mac: zo installeer je een taalmodel met Ollama
- RAG met Ollama en Qdrant als universele zoekmachine voor eigen gegevens
- llama2
- We hebben gequantiseerde LLM's getest: kosten- en prestatieresultaten | Latitude
- We hebben meer dan een half miljoen evaluaties uitgevoerd op gequantiseerde LLM's—dit hebben we ontdekt | Red Hat Developer
- Beste Ollama-modellen 2026: 25+ gerangschikt op VRAM en SWE-Bench (oktober 2026) | Morph
- Retrieval Augmented Generation (RAG): chat met eigen gegevens
- Retrieval Augmented Generation (RAG) voor LLM's | Prompt Engineering Gids
Veelgestelde vragen over de kwantisering van lokale AI-modellen
Wat betekent kwantisering bij een AI-taalmodel?
Kwantisering is een methode waarbij de numerieke precisie van de modelgewichten van een AI-taalmodel wordt verlaagd. Terwijl niet-gekwantiseerde modellen vaak met 16-bits- of 32-bits-drijvendekommagetallen werken, gebruiken gekwantiseerde varianten bijvoorbeeld nog slechts 8, 4 of zelfs 2 bits per gewicht. Daardoor neemt de benodigde opslagruimte aanzienlijk af, zonder dat het model in principe opnieuw hoeft te worden getraind. Het beslissende voordeel is dat ook grotere taalmodellen kunnen worden gedraaid op computers met beperkt werkgeheugen. Een model dat oorspronkelijk ongeveer 60 GB geheugen voor zijn gewichten nodig heeft, kan door 4-bits-kwantisering bijvoorbeeld worden teruggebracht tot ongeveer 15 tot 20 GB. De werkelijke grootte hangt af van de gebruikte kwantiseringsmethode. Bij de omzetting gaat echter informatie verloren, waardoor de antwoordkwaliteit afhankelijk van het model en de toepassing in verschillende mate kan worden aangetast.
Wat is het verschil tussen Q2, Q4, Q8 en FP16?
De aanduidingen Q2, Q4, Q8 en FP16 beschrijven verschillende precisieniveaus bij de opslag van de modelgewichten. FP16 gebruikt 16-bits-drijvendekommagetallen en biedt een hoge numerieke precisie, maar vereist daarvoor relatief veel werkgeheugen. Q8 verlaagt de gewichten tot ongeveer 8 bits en bereikt vaak een vrijwel ongewijzigde antwoordkwaliteit bij een duidelijk lager geheugengebruik. Q4 gebruikt overwegend 4 bits per gewicht en vormt daarom voor veel lokale toepassingen een bijzonder aantrekkelijk compromis. Het geheugengebruik daalt aanzienlijk, terwijl de kwaliteit bij veel modellen nog steeds op een hoog niveau blijft. Q2 comprimeert nog sterker, maar kan duidelijk grotere kwaliteitsverliezen veroorzaken. Belangrijk is dat deze aanduidingen alleen de basisprecisie beschrijven. Kwantiseringsvarianten zoals Q4_K_M gebruiken aanvullende methoden om de nauwkeurigheid van bijzonder belangrijke modelgewichten zo goed mogelijk te behouden.
Hoeveel werkgeheugen kan door kwantisering daadwerkelijk worden bespaard?
De mogelijke geheugenbesparing hangt af van de oorspronkelijke precisie, de modelgrootte en de gekozen kwantiseringsmethode. Ten opzichte van FP16 heeft een zuivere 8-bits-weergave ongeveer de helft van het geheugen voor modelgewichten nodig. Bij 4 bits daalt deze theoretische behoefte tot ongeveer een kwart. In de praktijk vallen de modellen iets groter uit, omdat er aanvullende informatie voor de kwantisering moet worden opgeslagen. Een taalmodel met 30 miljard parameters heeft in FP16 alleen al voor zijn gewichten ongeveer 60 GB nodig. Een 8-bits-variant heeft ongeveer 30 GB nodig, terwijl een 4-bits-versie vaak rond 18 tot 20 GB ligt. Deze waarden beschrijven echter niet het volledige werkgeheugengebruik tijdens het gebruik. Daarnaast moet onder meer rekening worden gehouden met het contextgeheugen, tijdelijke berekeningen en het besturingssysteem. Daarom moet bij de keuze van een model altijd voldoende geheugenreserve worden ingepland.
Hoeveel verslechtert Q4-kwantisering de antwoordkwaliteit van een taalmodel?
Bij veel moderne taalmodellen veroorzaakt een hoogwaardige 4-bits-kwantisering slechts relatief kleine kwaliteitsverliezen. Vooral bij alledaagse taken zoals tekstsamenvattingen, vertalingen, eenvoudige programmeertaken of algemene kennisvragen zijn de verschillen met hoger gepreciseerde varianten vaak nauwelijks te herkennen. De werkelijke kwaliteit hangt echter sterk af van het betreffende model en de taak. Bij complexe wiskundige berekeningen, veeleisende programmeertaken of meerstaps logische redeneringen kunnen kleine numerieke afwijkingen grotere gevolgen hebben. Ook de gekozen kwantiseringsmethode speelt een rol. Methoden zoals Q4_K_M proberen bijzonder gevoelige modelgebieden met hogere precisie te behouden. Voor veel gebruikers is Q4 daarom een zinvol uitgangspunt. Wie bijzonder betrouwbare resultaten nodig heeft, moet hetzelfde model daarnaast in Q8 testen en de antwoorden aan de hand van typische taken vergelijken.
Wanneer loont Q8 of FP16 zich in plaats van een kleinere Q4-versie?
Een hogere precisie kan met name zinvol zijn wanneer een taalmodel veeleisende taken moet uitvoeren en er voldoende werkgeheugen beschikbaar is. Daaronder vallen bijvoorbeeld complexe softwareontwikkeling, wetenschappelijke analyses, wiskundige berekeningen of uitgebreide analyses met meerdere opeenvolgende denkstappen. Q8 biedt daarbij vaak een goede middenweg. De modelgewichten hebben ongeveer twee keer zoveel geheugen nodig als bij een vergelijkbare 4-bits-kwantisering, maar de kwaliteit ligt daarvoor meestal zeer dicht bij de hoger gepreciseerde oorspronkelijke versie. FP16 komt vooral in aanmerking wanneer maximale numerieke precisie nodig is en de hardware het aanzienlijke geheugengebruik aankan. Een garantie op foutloze antwoorden biedt FP16 echter ook niet. Voor veel praktische toepassingen is een krachtiger model in Q4 mogelijk de betere keuze dan een duidelijk kleiner model in FP16.
Waarom kunnen 2-bits-gekwantiseerde AI-modellen problematisch zijn?
Bij een 2-bits-kwantisering zijn er aanzienlijk minder niveaus beschikbaar voor de weergave van de modelgewichten dan bij 4 of 8 bits. Daardoor kunnen taalmodellen weliswaar bijzonder sterk worden gecomprimeerd, maar kunnen belangrijke informatie over de samenhangen binnen het neurale netwerk verloren gaan. Deze verliezen treden niet noodzakelijk op bij eenvoudige vragen. Moeilijkheden ontstaan vaak pas bij complexere taken die nauwkeurige berekeningen, langere gedachtegangen of de betrouwbare verwerking van omvangrijke informatie vereisen. De antwoorden kunnen dan onnauwkeuriger, tegenstrijdiger of minder stabiel worden. Bijzonder problematisch is dat zulke kwaliteitsverliezen niet altijd duidelijk zichtbaar zijn. Een model kan nog steeds overtuigend formuleren, hoewel de resultaten feitelijke fouten bevatten. Q2 is daarom vooral geschikt voor experimentele toepassingen of situaties met zeer beperkt geheugen. Voor veeleisende productiesystemen zijn Q4 en Q8 meestal de betrouwbaardere basis.
Welke verschillen bestaan er tussen GGUF, MLX en Safetensors?
GGUF, MLX en Safetensors worden vaak genoemd in verband met lokale AI-modellen, maar vervullen verschillende taken. GGUF is een modelformaat dat vooral in de omgeving van llama.cpp, Ollama en LM Studio gangbaar is. Het ondersteunt verschillende kwantiseringsmethoden en maakt de uitvoering van taalmodellen op verschillende hardwareplatforms mogelijk. MLX is daarentegen een door Apple ontwikkeld machine-learning-framework dat speciaal is gericht op de architectuur van Apple Silicon. Met MLX kunnen taalmodellen efficiënt worden uitgevoerd op Macs met M-processors. Daarvoor zijn ook speciaal gekwantiseerde modelvarianten beschikbaar. Safetensors is een veilig bestandsformaat voor de opslag van numerieke modelgewichten. Het wordt vaak gebruikt in de omgeving van Hugging Face en PyTorch. De keuze van het formaat hangt dus af van de gebruikte runtime-omgeving. Op Apple Silicon-Macs kunnen zowel GGUF- als MLX-modellen zinvol zijn, waarbij hun snelheid afhankelijk van het model en de implementatie verschilt.
Worden gekwantiseerde AI-modellen automatisch sneller?
Niet per se. Kwantisering verlaagt in de eerste plaats het geheugengebruik van een model. Daardoor hoeven tijdens de verwerking vaak minder gegevens uit het werkgeheugen te worden gelezen, wat vooral bij berekeningen die afhankelijk zijn van geheugenbandbreedte aanzienlijke voordelen kan opleveren. Op Apple Silicon-Macs is dit effect bijzonder interessant, omdat CPU en GPU toegang hebben tot een gemeenschappelijke geheugenpool. Kleinere modelgewichten kunnen efficiënter worden overgedragen en verwerkt. Daarom bereiken gekwantiseerde modellen in veel gevallen een hogere snelheid bij de tekstgeneratie. De verwerking van gekwantiseerde gewichten vereist echter soms aanvullende rekenbewerkingen om geschikte getalswaarden te herstellen. Welke variant daadwerkelijk sneller is, hangt daarom af van de hardware, de gebruikte software en de concrete kwantiseringsmethode. Naast de pure snelheid in tokens per seconde moet ook de tijd tot het eerste antwoord in aanmerking worden genomen. Juist bij interactieve toepassingen kan een snelle reactietijd belangrijker zijn dan de maximale generatieprestatie.
Welk kwantiseringsniveau is geschikt voor Macs met 16, 32, 64 of 128 GB werkgeheugen?
De geschikte kwantisatie hangt zowel af van de beschikbare geheugencapaciteit als ook van de grootte van het gewenste taalmodel. Op Macs met 16 GB Unified Memory zijn vooral kleinere modellen met enkele miljarden parameters geschikt. Door Q4-kwantisatie kunnen zelfs individuele grotere modellen bruikbaar worden, mits er voldoende geheugen overblijft voor het besturingssysteem en de context. Met 32 GB werkgeheugen kunnen talrijke modellen uit de 7B- tot 14B-klasse comfortabel worden uitgevoerd. Ook grotere, sterk gekwantiseerde modellen zijn deels mogelijk. Bij 64 GB zijn er al aanzienlijk meer mogelijkheden voor modellen met 30 miljard parameters of uitgebreidere contextvensters beschikbaar. Macs met 128 GB Unified Memory bieden daarnaast ruimte voor bijzonder grote modellen, hogere precisieniveaus en het parallel draaien van meerdere AI-componenten. De werkelijke modelgrootte blijft doorslaggevend. Het aantal parameters, de kwantisatie, de contextlengte en de modelarchitectuur moeten altijd gezamenlijk worden bekeken.
Wat gebeurt er wanneer een AI-model meer werkgeheugen nodig heeft dan de Mac kan bieden?
Wanneer een taalmodel te veel werkgeheugen nodig heeft, kan macOS proberen delen van de data naar de SSD te verplaatsen. Dit zogenaamde swapping voorkomt onder bepaalde omstandigheden een onmiddellijke programma-afsluiting, maar leidt bij geheugenintensieve AI-toepassingen vaak tot aanzienlijke prestatieverliezen. De reden hiervoor is dat zelfs snelle SSD's een aanzienlijk lagere gegevensoverdrachtssnelheid bereiken dan het interne werkgeheugen. Als er tijdens de tekstgeneratie constant tussen de SSD en het RAM gewisseld moet worden, kan de antwoordsnelheid drastisch dalen. Daarnaast komt het feit dat macOS niet het gehele Unified Memory onbeperkt beschikbaar stelt voor AI-toepassingen. Het besturingssysteem, de grafische interface en andere programma's hebben ook geheugen nodig. Wie dergelijke problemen wil vermijden, zou eerst niet-gebruikte applicaties moeten sluiten, de contextlengte moeten verminderen of een sterker gekwantiseerde modelvariant moeten gebruiken. Juist bij grotere taalmodellen is een voldoende geheugenreserve cruciaal voor een stabiele en vloeiende werking.
11. Welke rol speelt kwantisering bij RAG-systemen en de verwerking van eigen documenten?
Bij Retrieval-Augmented Generation (RAG) worden taalmodellen gecombineerd met een externe kennisbron. Documenten worden eerst opgedeeld in kleinere secties en met behulp van een embedding-model omgezet in numerieke vectoren. Een vectordatabase maakt vervolgens het zoeken naar inhoudelijk passende documentsecties mogelijk. Kwantisatie kan hierbij op verschillende plaatsen worden ingezet. Het genererende taalmodel kan bijvoorbeeld in Q4 worden uitgevoerd om werkgeheugen te besparen. Bij het embedding-model en bij het opslaan van de vectoren moet er daarentegen extra op worden gelet dat de kwaliteit van de gelijkeniszoekopdracht behouden blijft. Te agressieve compressie kan ertoe leiden dat relevante documentsecties minder goed worden gevonden. Zelfs een krachtig taalmodel ontvangt dan mogelijk niet de informatie die het nodig heeft voor een correct antwoord. Daarom moeten bij RAG-systemen zowel de kwaliteit van de documentzoekopdracht als de antwoordkwaliteit van het taalmodel apart worden gecontroleerd.
12. Hoe vind ik de optimale kwantisering voor mijn lokale AI-systeem?
De beste kwantisatie kan niet alleen worden bepaald op basis van de modelgrootte of een benchmark-tabel. Doorslaggevend is welke taken het taalmodel in de praktijk moet vervullen en welke hardware daarvoor beschikbaar is. Een zinvolle instap is om eerst een hoogwaardige Q4-variant van het gewenste model te installeren. Vervolgens kunnen typische taken worden uitgevoerd, zoals tekstsamenvattingen, programmeertaken, vertalingen of de analyse van eigen documenten. Hierbij is het aanbevolen om de antwoordkwaliteit, snelheid, het geheugengebruik en de betrouwbaarheid te observeren. Als er voldoende geheugen aanwezig is, kan hetzelfde model aanvullend in Q8 worden getest. De resultaten kunnen vervolgens direct worden vergeleken. Het is belangrijk om voor beide varianten zo identieke testcondities mogelijk te gebruiken. Alleen zo worden verschillen werkelijk zichtbaar. Uiteindelijk is niet de hoogste precisie doorslaggevend, maar de combinatie van voldoende kwaliteit, goede snelheid en een stabiele uitvoering op de aanwezige hardware.